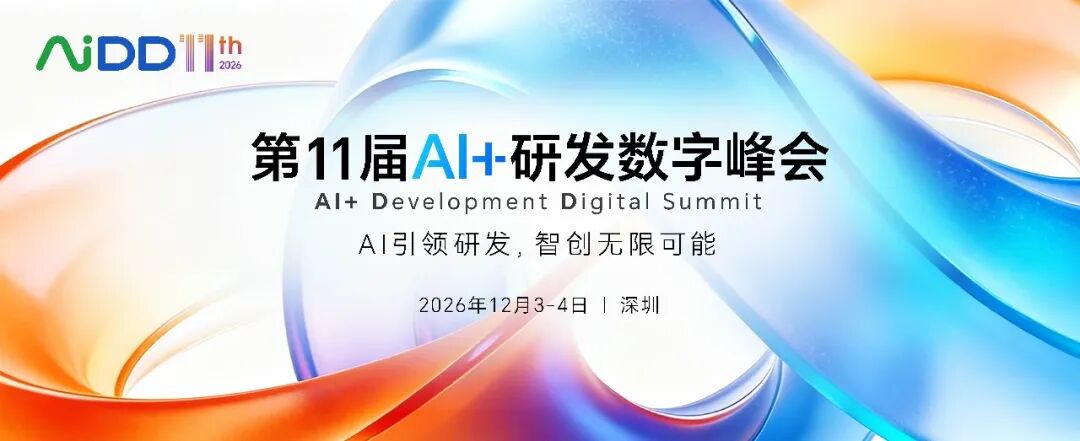
在人工智能技术迅猛发展的当下,为了帮助企业在人工智能的浪潮中抓住机遇,“AI+研发数字峰会(AiDD)”应时而生,致力于协助企业利用AI技术深化计算机对现实世界的理解,推动研发进入智能化和数字化的新时代。AiDD峰会是兼具专业性、专注性、全面性与前瞻性的顶级 AI 数字峰会。
论坛出品人:刘名威(中山大学 副教授)
本论坛聚焦AI Agent在真实任务中的能力评测,讨论如何建立更可信、更多维度、更可比较的评测体系。论坛将围绕基准集构建、指标设计、对比测试、结果解释、鲁棒性分析、可解释性验证等主题展开,进一步探索在迭代中如何基于评测结果持续改进AI Agent。听众将获得评估智能体能力、判断模型优劣、支撑选型优化的系统方法。
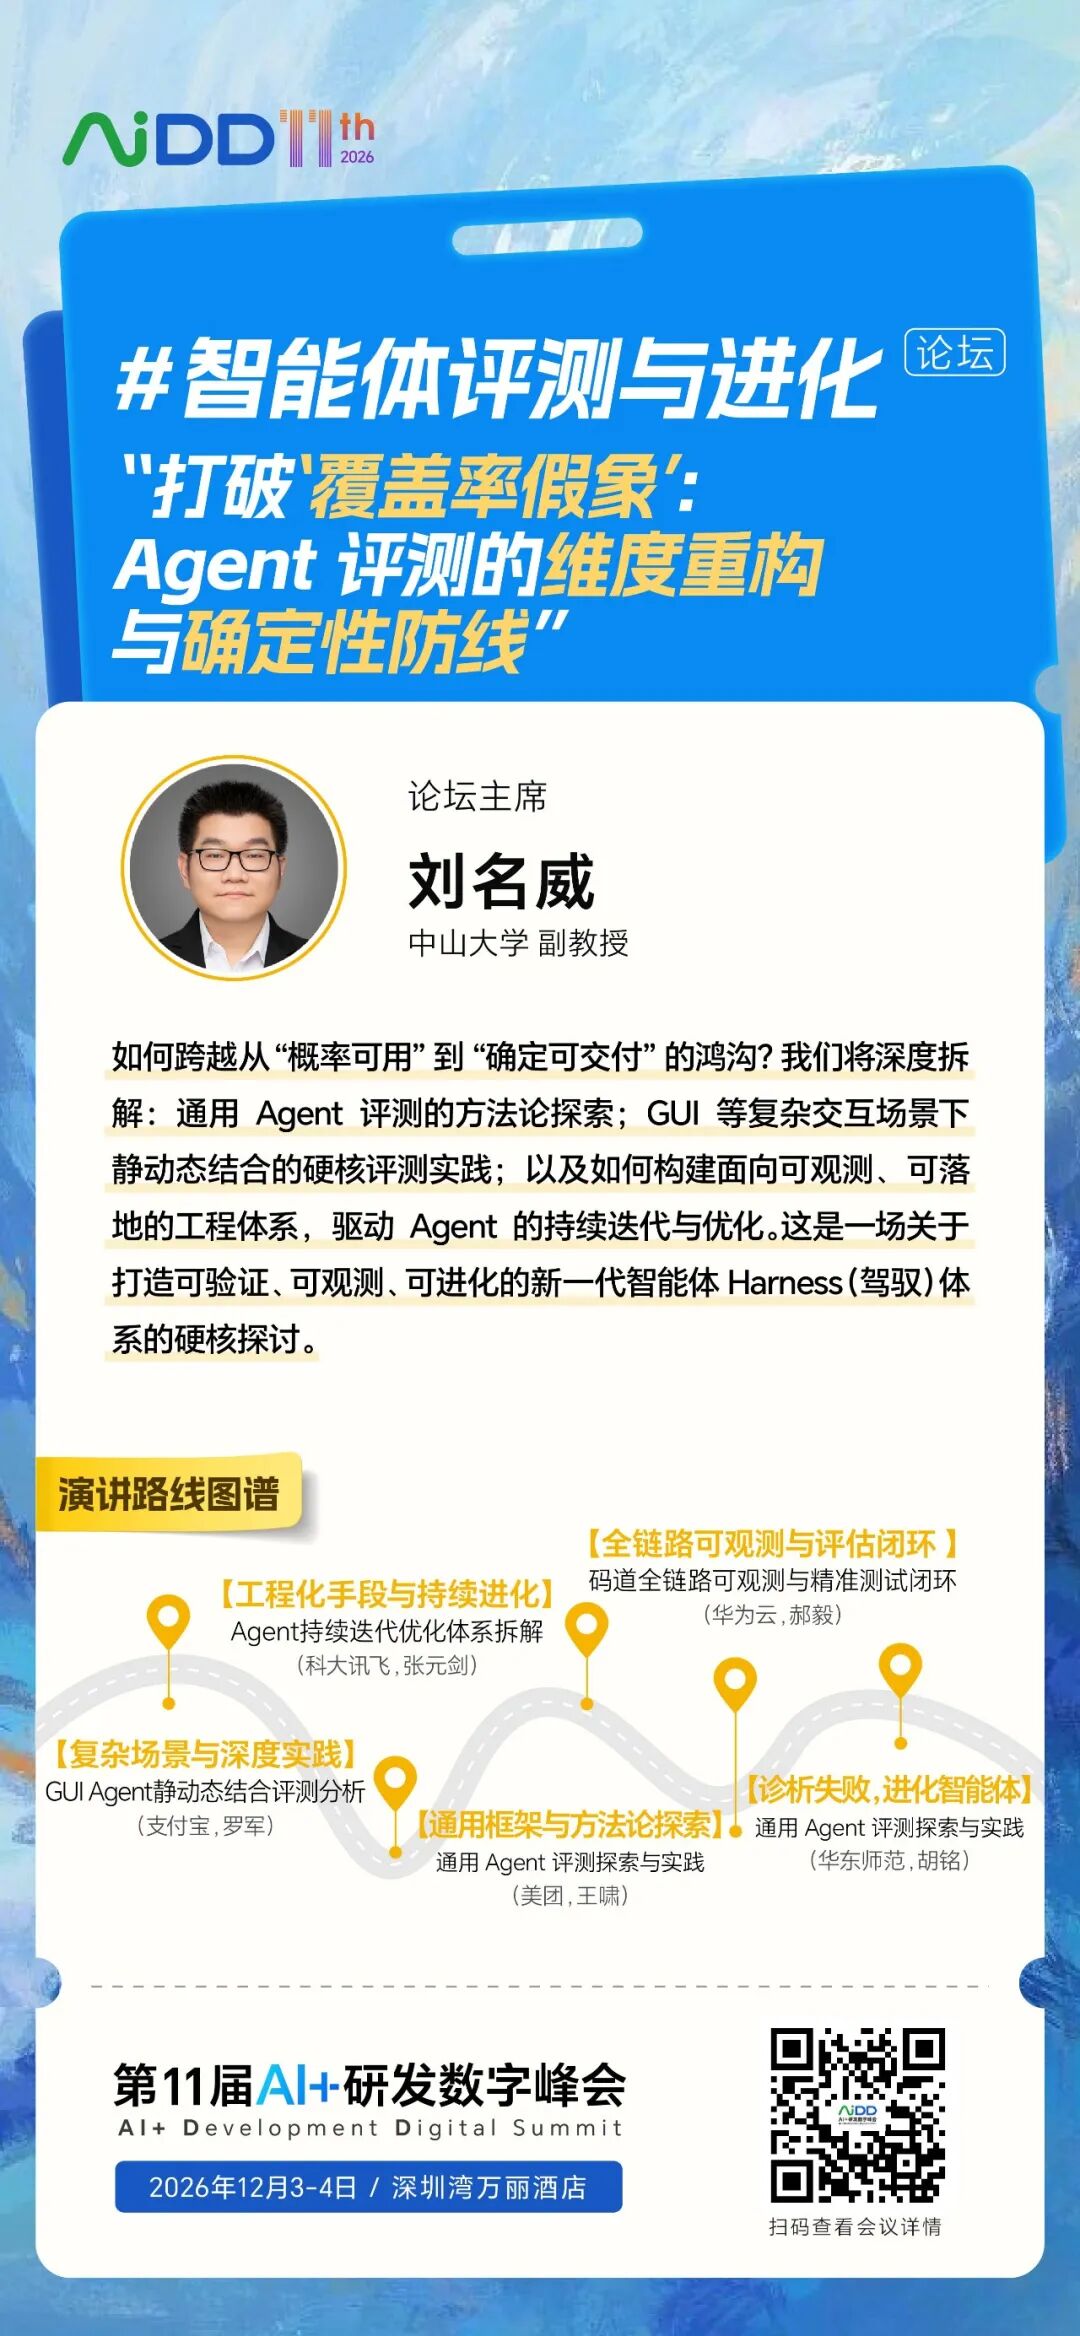
—— 罗军 | 支付宝 AI多模态评测负责人
内容亮点:
直击评测痛点:剖析静态 benchmark 难映射真实任务、动态 benchmark 难解释失败根因的行业困境。
一体化体系设计:首创“动态任务先构造、静态能力后拆解”方法,打通端到端评测、细粒度诊断与自动化评测。
工程踩坑实录:分享高保真 sandbox 设计、trajectory-based judge 实践,以及应对答案泄漏、Ask 机制失真等典型问题的解法。
听众收益:
—— 张元剑 | 科大讯飞 教育测试公共技术组负责人
内容亮点:
范式转型:深度对比传统大模型评测与 Agent 端到端实测的本质差异,梳理落地痛点。
自闭环评估体系:搭建“离线测评底座 + 线上可观测能力”联动体系,打通“问题发现→根因归因→样本回流→回归测评”的闭环飞轮。
自动化平台建设:沉淀人工评估经验,构建 AI 自动评估四大核心支撑能力,大幅降低人工打分依赖。
听众收益:
—— 王啸 | 美团 基础研发Agent平台部CatPaw评测负责人
内容亮点:
体系梳理:从评测定义出发,系统梳理 Agent 核心能力方向与关键指标体系,阐述自建评测集的设计思路。
长程任务攻坚:聚焦长程任务评测挑战,深入探讨 Harness 评测的对比优化,以及与模型联合优化的闭环实践。
前沿探索:首次公开分享 Advisor 技术评测的实战经验与洞察。
听众收益:
—— 郝毅 | 华为云 AI工具链测试专家 / CodeArts产品测试部部长
内容亮点:
双闭环破局:针对代码智能体“用得越多、信得越少”困局,提出“全链路可观测 + 精准化测试”双闭环评估体系。
四维黄金指标:以“快、准、稳、省”定义好智能体,建立 LLM 到 Agent 分层门禁与 Eval-Driven CI 自动闭环。
“建字典、查字典”方法论:首创三段式分析链路(代码→特性→用例),实现变更动态触发、秒级精准收敛。
听众收益:
—— 胡铭 | 华东师范大学 研究员
内容亮点:
可信评测:探讨多智能体执行中的典型失败传播过程,以及如何区分有效改进与执行结果的随机变化。
技能自进化:提出从分散的执行经验中积累、组织、验证可复用能力的路径,提升系统效率与稳定性。
协同演化:分享分布式场景下,隐私约束中的多方经验共享、冲突处理与能力退化控制思路。
听众收益:
论坛出品人:李华伟(阿里巴巴 研发效能技术专家)
本论坛聚焦测试智能体的工程平台建设,研究如何通过Harness把测试任务标准化、模块化、平台化,支撑多场景协同落地。论坛将讨论自动调度、资产复用、链路编排、效能评估、工具集成、持续治理等主题,强调平台如何承接测试智能化的规模扩展需求。听众将理解如何搭建可复用、可运营、可演进的智能测试平台。
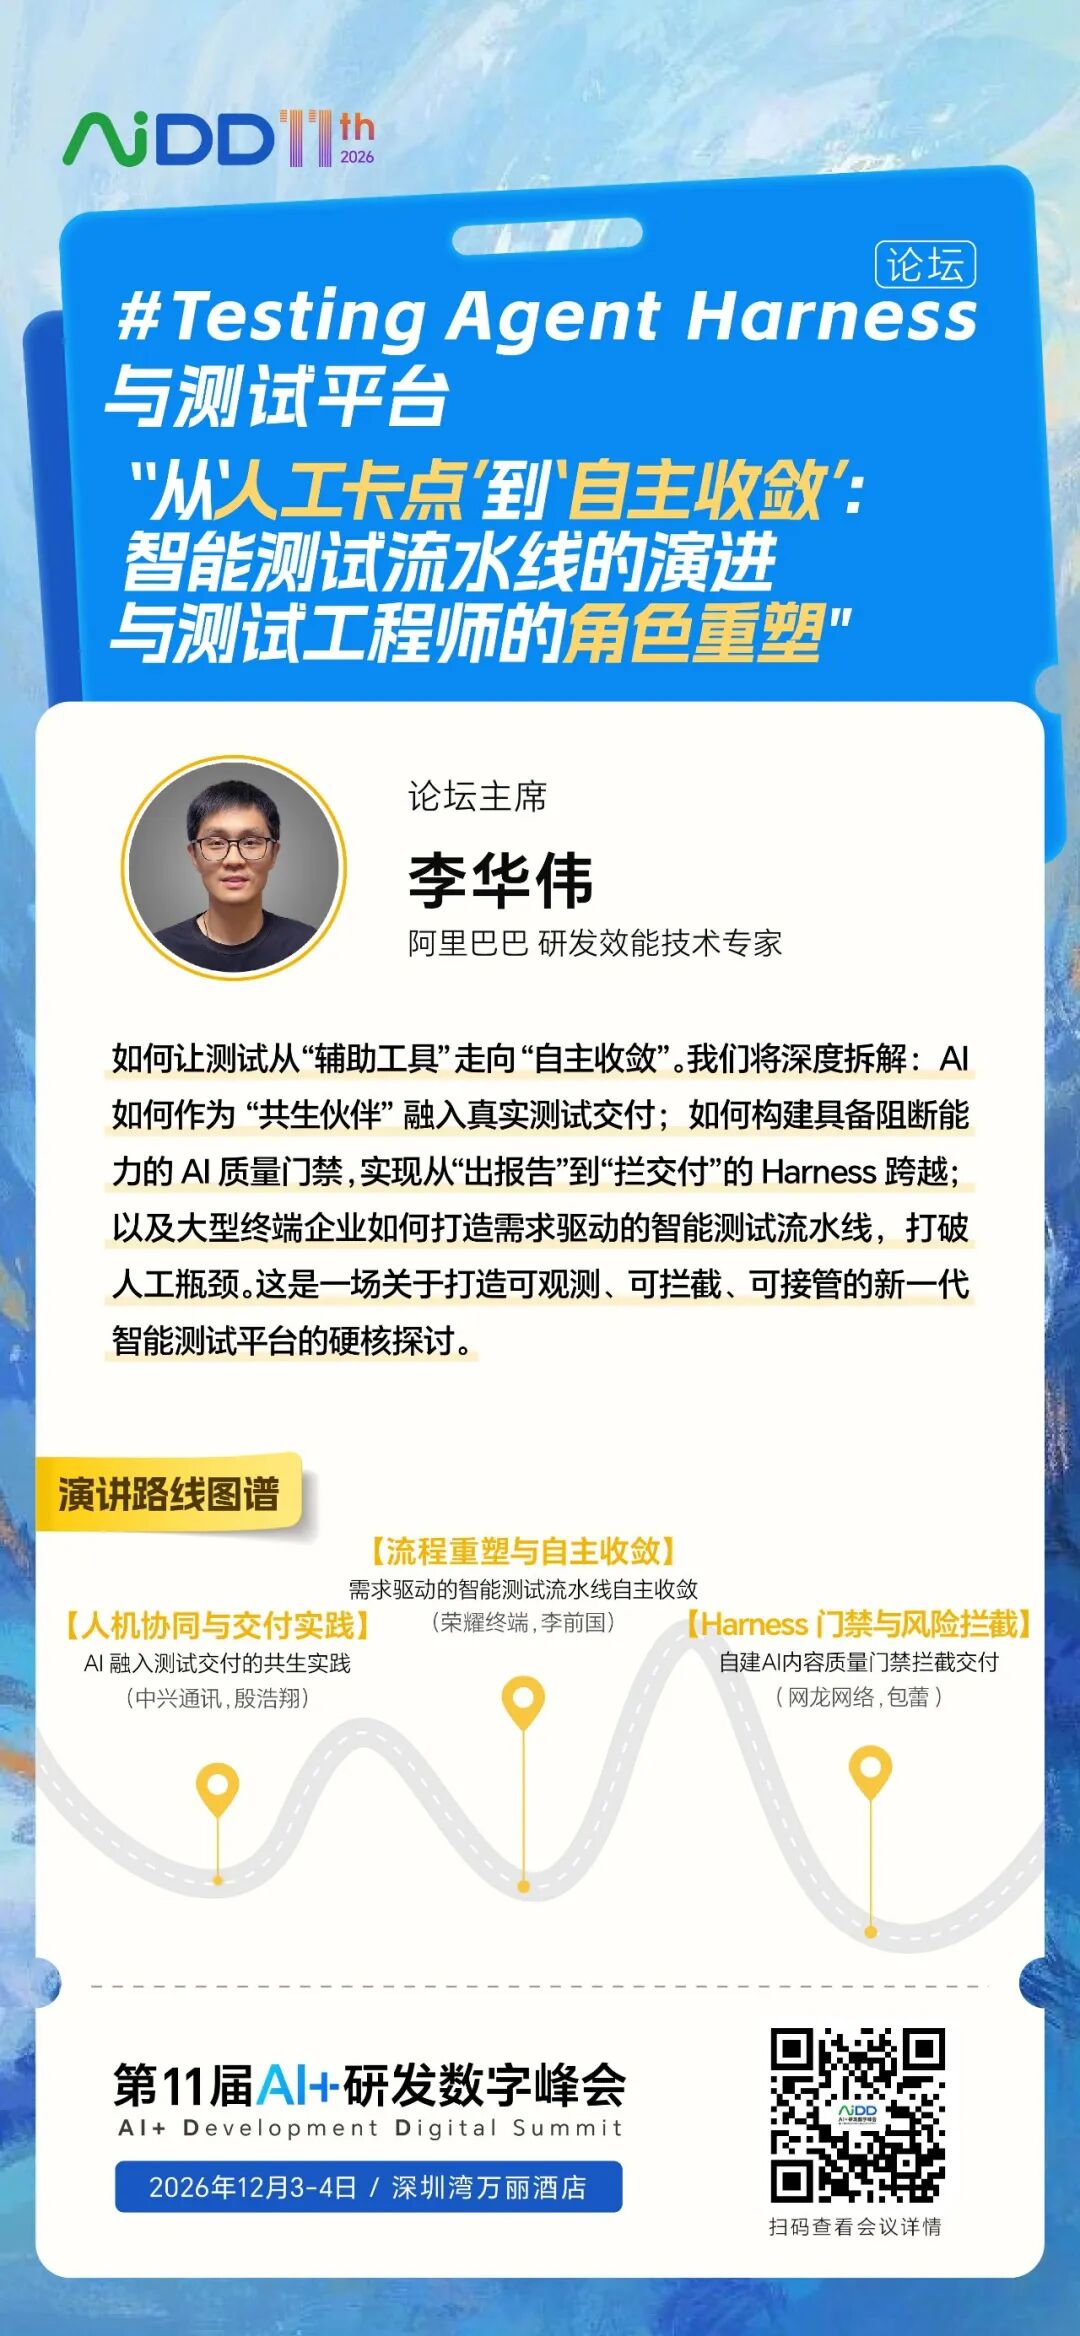
—— 殷浩翔 | 中兴通讯 有线院数据中心 AI应用开发专家
内容亮点:
四步破局:通过“知识标准化、低成本生产、智能消费、流程内沉淀”,打破测试脚本编写高度依赖专家经验的瓶颈。
关键技术:应用知识逆向重构“减熵”、AI+Web 融合(页面即上下文、对话即操作)、多厂商测试仪统一 API 界面化。
显著成效:方案覆盖 900+ 需求,AI 累计生成代码 200W+ 行,脚本生成采纳率超 85%,需求交付效率提升 30%。
听众收益:
—— 李前国 | 荣耀终端 测试架构师
内容亮点:
联邦架构:基于 Claude Code 构建 7-Skill 联邦拓扑(编排层+5个领域子Skill+mock旁路),以 state.json 支撑断点续跑。
卡点分级与失败闸门:明确人工与自动卡点边界;首创“环境重试/脚本修复/缺陷报单”三分类决策,严防 AI 自愈机制吞掉真 Bug。
证据化收敛:设定“覆盖率提升 ≥5% 才允许继续循环”的硬判据,用三层证据链证明补充用例的真实价值。
听众收益:
直接拿走:“卡点分级决策表”与“失败分类闸门规则”,避开“全自动=全去掉人工”的深坑。
直接复用:一组覆盖率收敛控制参数(目标85%/底线60%/上限3轮/每轮提升≥5%),以及完整的跨阶段复利出错踩坑复盘。
—— 包蕾 | 网龙网络 AI Native Engineer
内容亮点:
真拦截机制:将评测接入在线交付路径,实行“确定性规则硬拦截 + LLM 判官软评分”,拦下即定位、自动修复、复检通过才交付。
攻克在线四大约束:针对性解决时延预算超标、门禁静默失效、误拦代价不对称、判词描述失真等常规离线评测不会遇到的“要命”问题。
门禁可信度建设:判据与判官模型版本化管理,评测器自测,用数据给指标做减法。
听众收益:
论坛出品人:郭晓辉(平安人寿 科技研发/质量管理团队副总经理)
本论坛聚焦测试能力从“人主导、AI辅助”迈向“Agent自主驱动”的转变,探讨智能测试如何应对复杂业务、海量数据和快速迭代带来的压力。论坛将围绕场景生成、用例构造、自动执行、缺陷识别、边界探索、报告复盘等主题展开,分享AI Agent在测试设计和执行中的实践路径。听众将获得构建新一代智能测试体系的思路与方法。
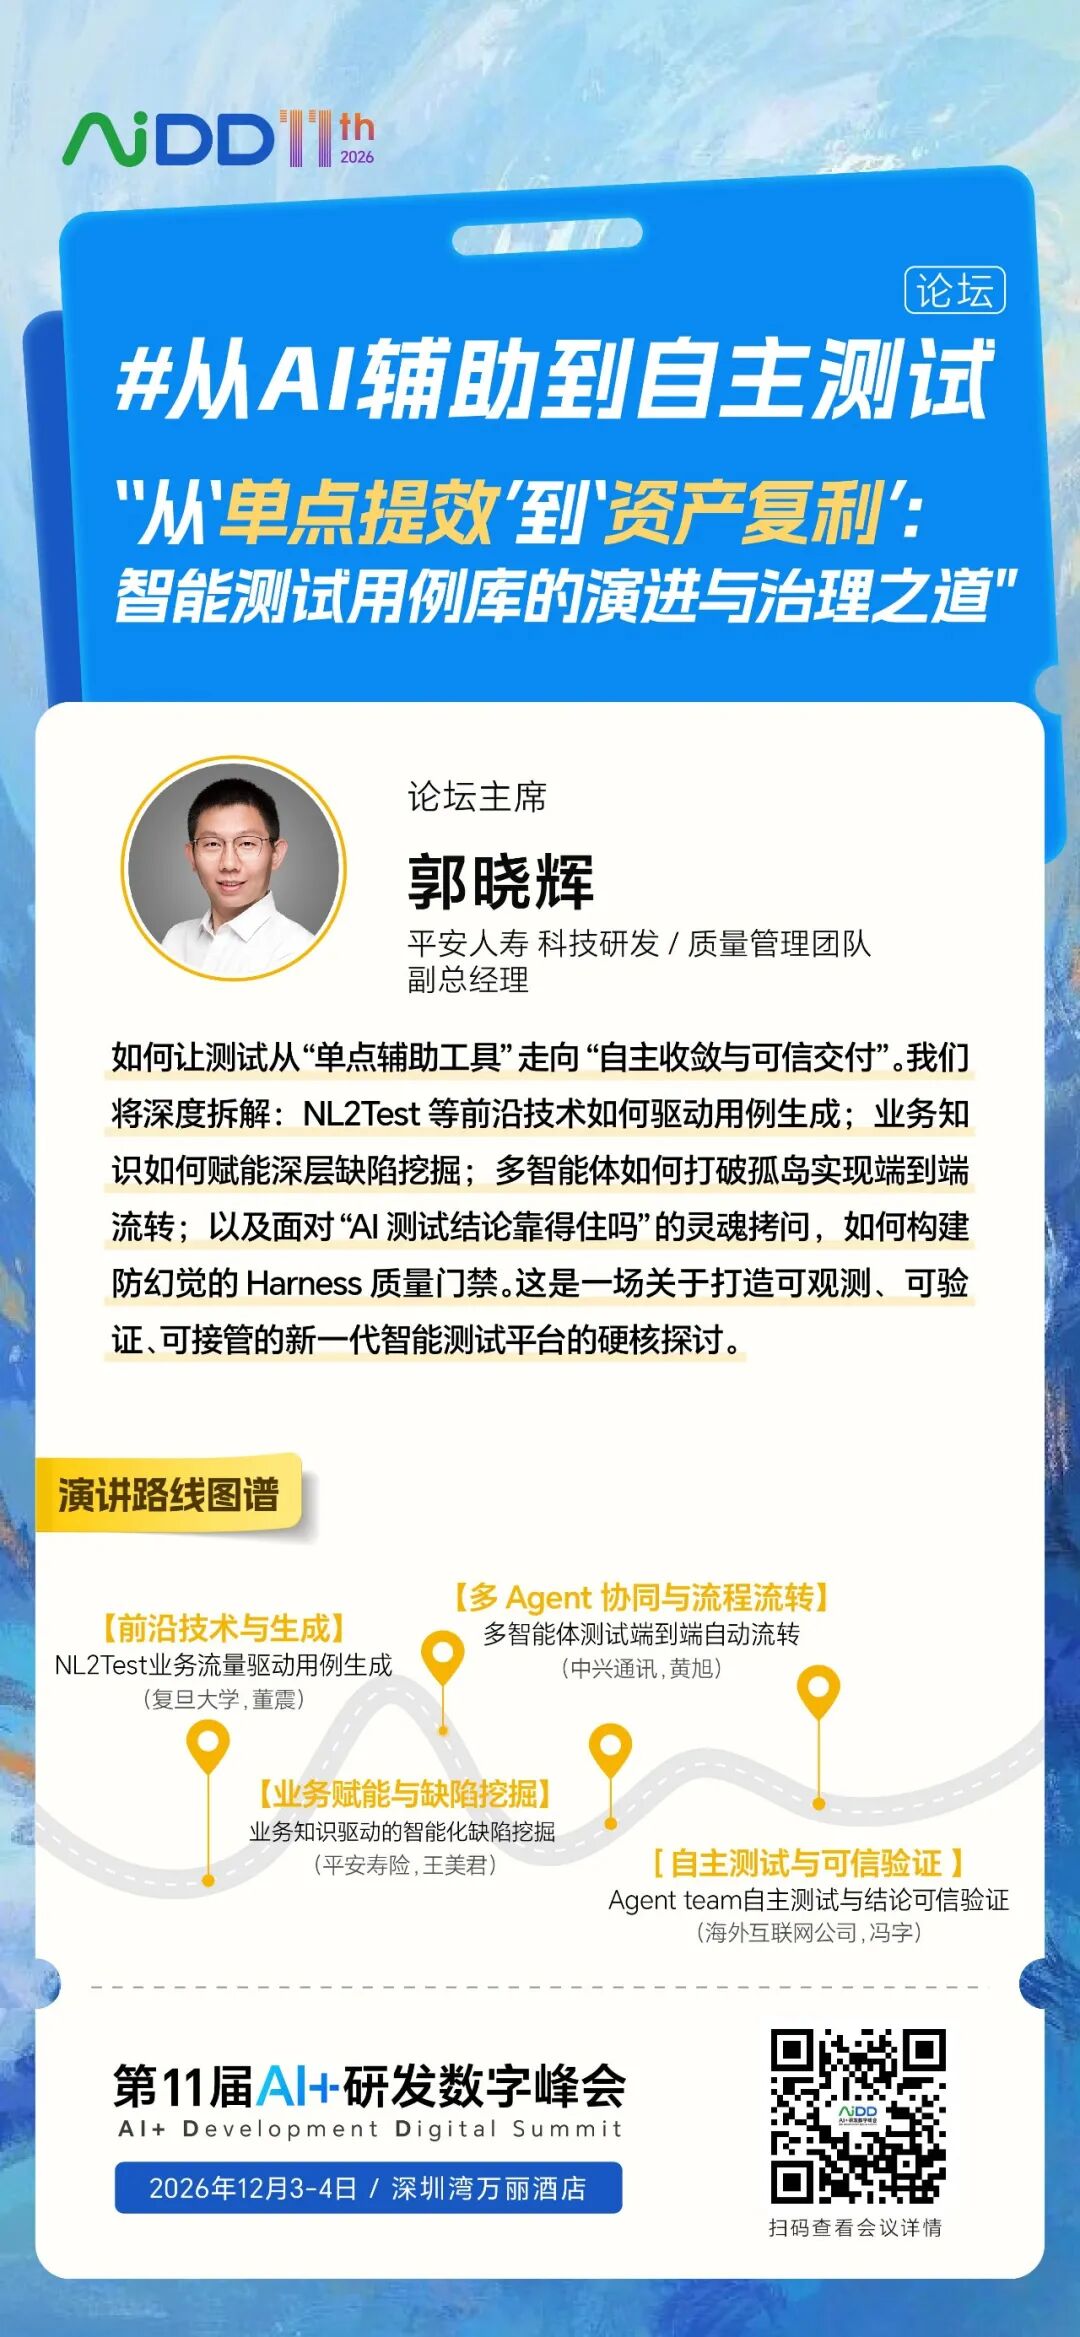
—— 董震 | 复旦大学 计算与智能创新学院副教授、博导
内容亮点:
学术与工业结合:分析从流量录制到可重放测试、从代码可执行到业务验证正确的核心差距。
NL2Test 流程:分享面向业务场景的测试生成流程,包括请求筛选、动态数据依赖恢复及结合语义理解的确定性校验。
RESTOR 强化学习:探讨基于执行反馈的奖励设计与模型优化,平衡断言覆盖、验证强度与稳定性。
听众收益:
—— 王美君 | 平安寿险 质量部门测试经理
内容亮点:
双向融合破局:打破纯代码扫描模式,实现“代码 + 业务知识”双向融合,应对寿险复杂业务测试挑战。
五维架构体系:围绕“目标—活动—方法—工具—人员”构建 AI 测试体系,依托“大模型+知识库+智能体”三层架构全链路赋能。
知识产权布局:项目已形成系统化知识产权布局,累计提交 AI 测试相关专利提案 26 项。
听众收益:
—— 黄旭 | 中兴通讯 AI应用(软件)TSE
内容亮点:
三层协同体系:构建“总控智能体(动态调度)— 管理智能体(DOD校验与状态翻转)— 业务智能体(测试设计/执行/脚本开发等)”架构。
流程重塑:解决测试流转中断点多、系统切换频繁、AI 未嵌入流程的痛点,推动测试交付从人工串联走向多智能体协同自动流转。
听众收益:
—— 冯宇 | 海外数字资产公司 测试负责人
内容亮点:
全流程接管:一名 QA 带领一组 Claude Agent,4个月完成 10 个版本、80 个需求的七步流程(需求分析到测试报告)。
三类错误剖析:基于 130+ 真实踩坑记录,将 AI 测试错误精准归类为:对象错误、工具失效、前提错误,并辅以真实案例。
多层质量关卡:分享如何通过 CLAUDE.md、Skill、Memory、双知识库和多 Agent 并行,为每一步设置质量关卡。
听众收益:
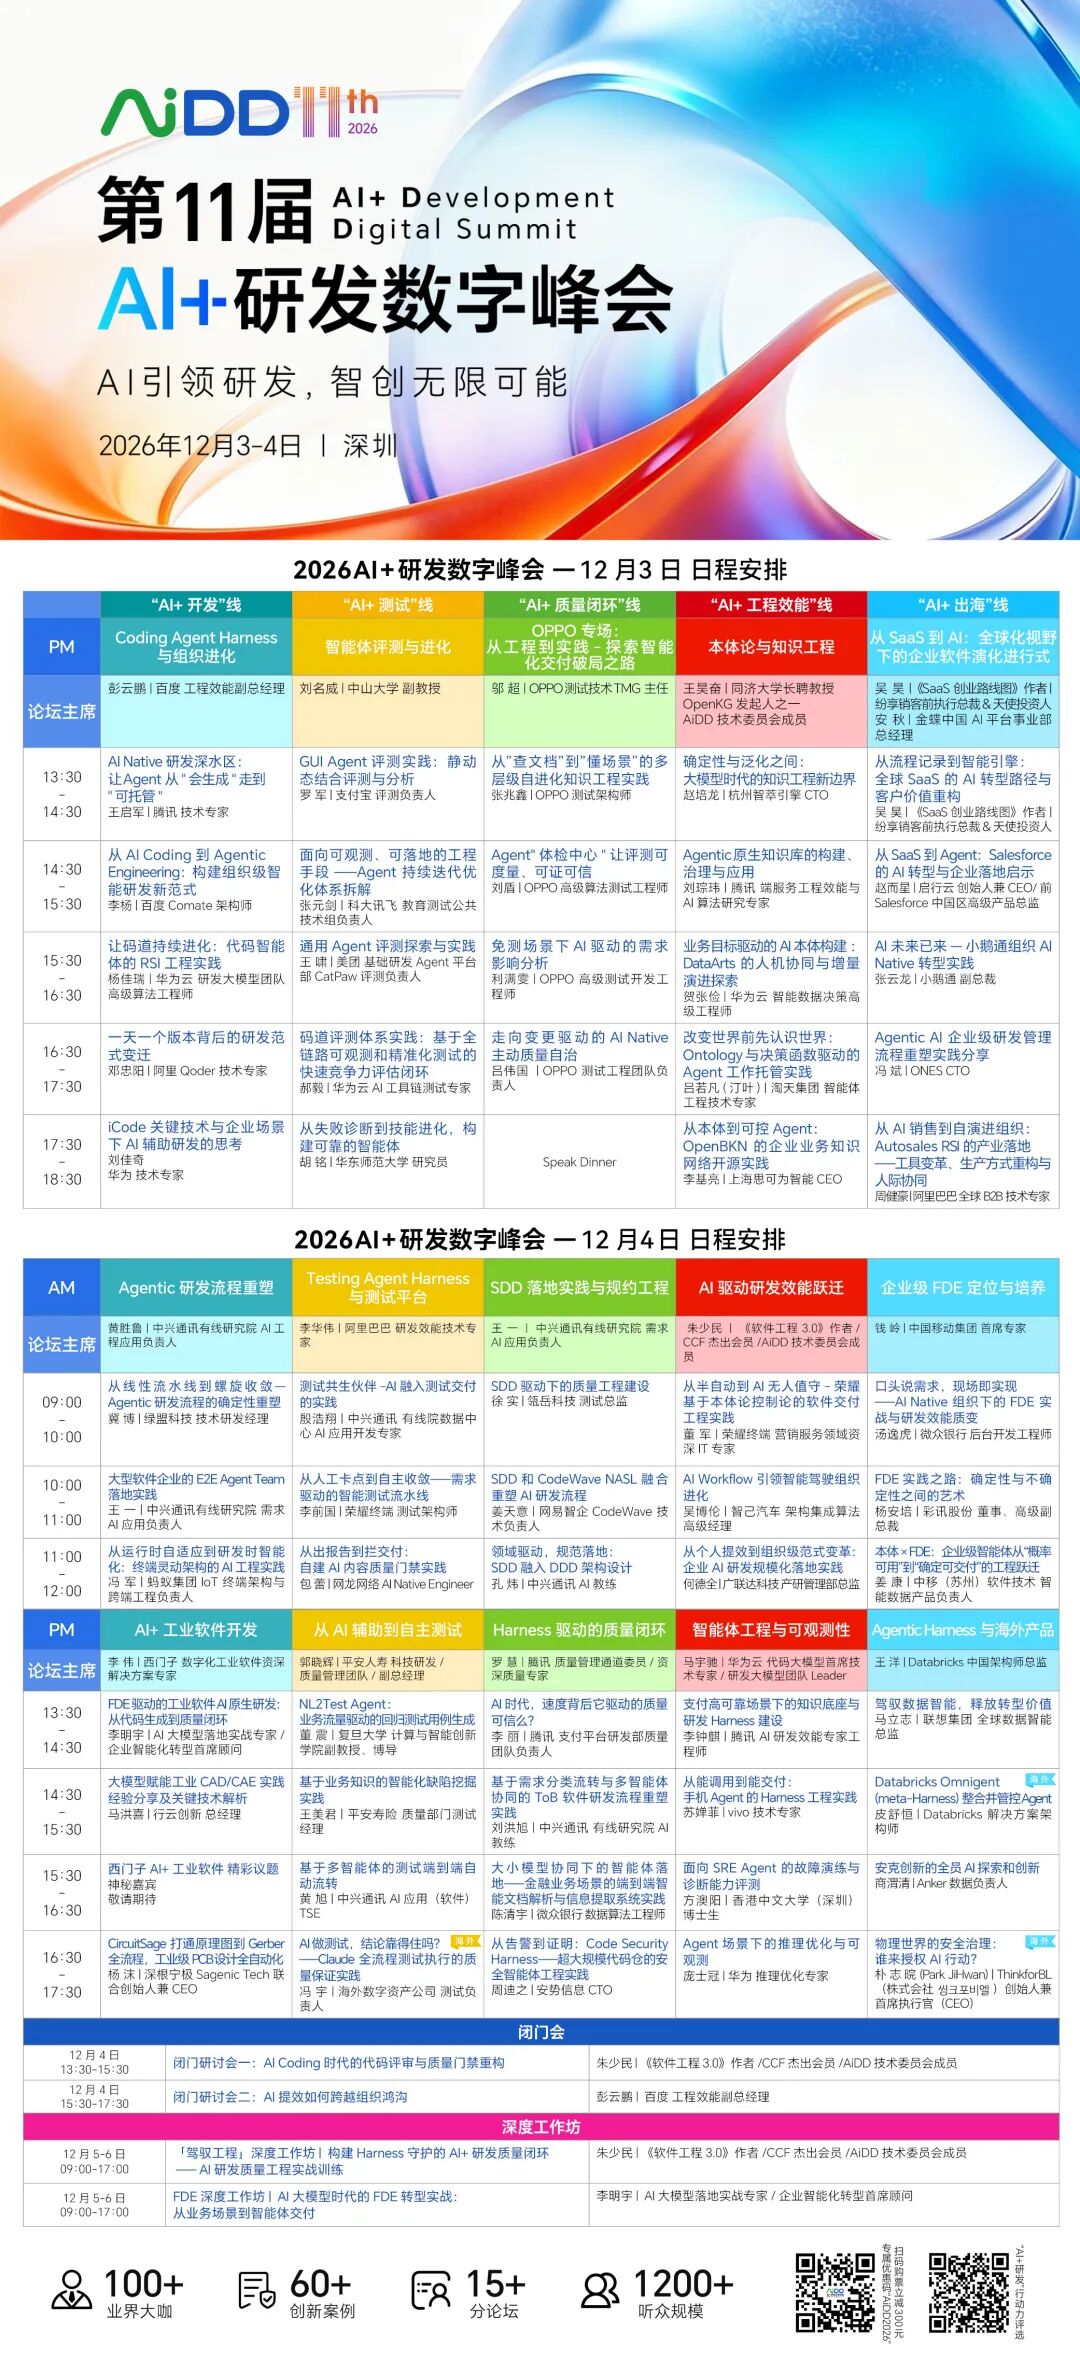
大会时间:2026年12月3日 - 4日
大会地点:中国 · 深圳
完整日程与早鸟报名:www.aidd.vip/2026-shenzhen-schedule
互动福利:
在评论区留言 “你最期待的演讲嘉宾或话题”,我们将抽取 1 位幸运读者,送出 AiDD 峰会单日通票或独家闭门会参与资格!
立即扫码报名,与顶尖技术大脑同行,抢占 AI 研发新范式先机!

北京营销中心
北京通州北京ONE国际广场10层

上海研究中心
上海市浦东软件园

厦门研究中心
厦门观音山国际商务运营中心

海外市场中心
香港中环香港站国际金融中心
 加入智库
 成为客户