作者:亢江妹(KK)——Inspire总监级咨询师、AI X及产品社区领头人,拥有20年大型企业产品管理经验。聚焦AI2.0解决方案、数智化转型规划、企业级AI应用落地及AI人才体系培养。
前段时间在 AiDD 成都站,我以《从 PRD 到 Specs:AI 重塑需求工程》为题做了分享。这篇文章是那场分享的完整展开。这里说的「重塑」,重点不在让 AI 替产品经理写 PRD,而在重新设计需求的生产方式:输入怎么组织、流程怎么拆、门禁怎么设、知识怎么沉淀。
这篇文章想回答四个问题:为什么编码自动化之后,卡点从开发挪到了需求;为什么以 OpenSpec 为代表的传统 SDD 只解决了产品流程的最内环;怎么把 AI 扩展到产品规划和需求端,形成一条端到端的方法;以及组织要改哪些角色、机制和节奏,才能真正落地。
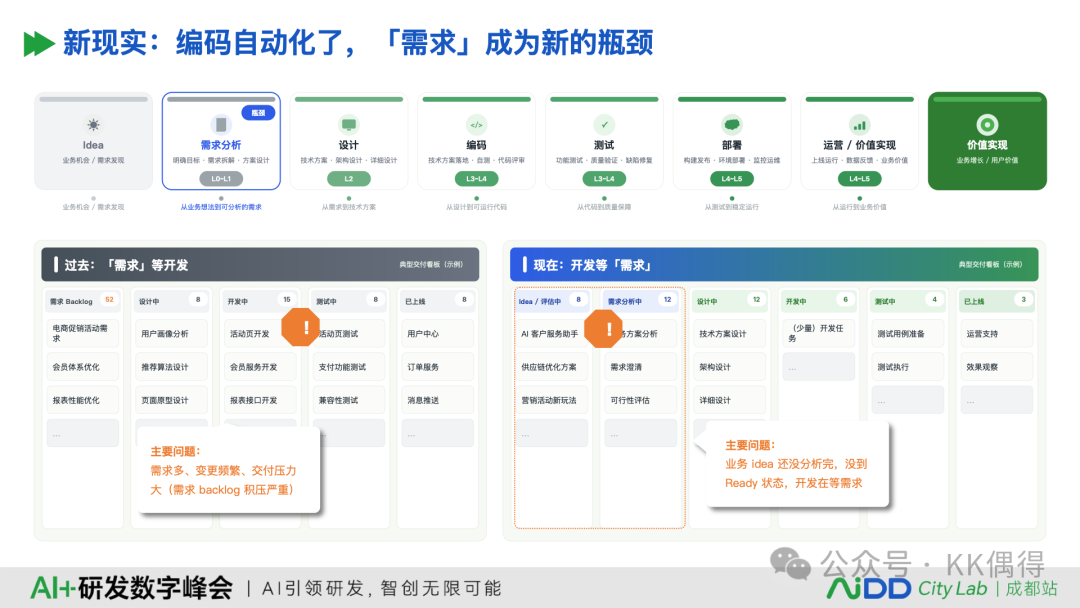
看板上的数字只是表象。变化的是等待关系:过去是需求在等开发排期,现在是开发在等需求达到 Ready。等待关系一变,整个交付系统的约束点就换了位置。
这背后是一个正在发生的结构性变化。大模型明显抬高了实现吞吐的上限:代码生成、样板搭建、重构迁移都比以前快。当写代码这段路被拓宽之后,原本被它掩盖的上游问题就暴露出来了:需求不可验证、变更不可控、影响不可追溯。
这也解释了一个容易被忽略的事实:编码提效并不会自动带来端到端提效。如果需求侧仍然按原来的方式工作,编码越快,上游的积压越明显。局部吞吐提升了,系统吞吐反而被需求侧的等待卡住。稀缺的东西变了。以前是把东西写出来,现在更缺的是可追溯、可测试、可审计的需求定义与验收口径。
需求到底为什么慢?在分享里我把它拆成五个维度:工具、流程、组织、知识、人。这五个维度相互咬合,只改一个,效果往往有限。
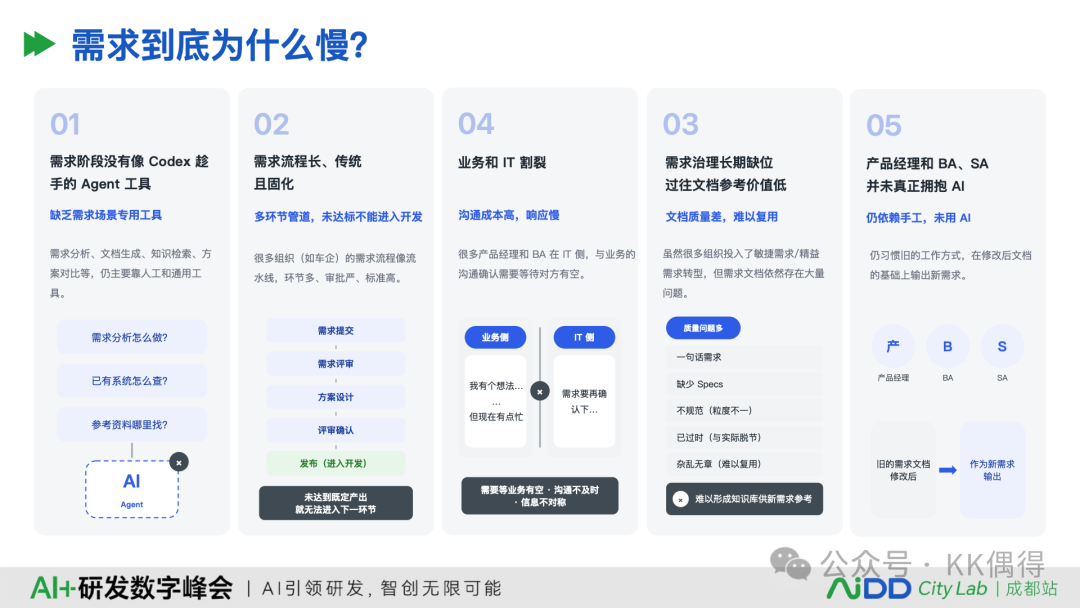
先说工具和流程。需求阶段没有像 Codex 一样趁手的需求 Agent,需求分析、文档生成、知识检索、方案对比仍然主要靠人工和通用工具;同时,很多组织的需求流程长、传统且固化,未达标就不能进入开发。尤其在一些大型组织里,需求流程像流水线,环节多、审批严、标准高。前者缺的是一套能承接操作型任务的需求侧工作台,后者缺的是允许不同域团队采用不同流程的空间。把这两件事放在一起看,就会发现:需求人员并不缺努力,问题更多出在工具和流程还停留在上一个时代。
组织和知识的问题更隐蔽。业务与 IT 割裂,角色之间来回传递,沟通不及时、信息不对称;需求治理长期缺位,过往文档参考价值低,一句话需求、缺少 Specs、粒度不一、已经过时、杂乱无章。前者让信息在传递中损耗,后者让知识无法复用。破局的方向,一是尽可能让割裂的角色融合,缩短沟通路径;二是借鉴 OpenSpec 的 /archive 机制,让 AI 把知识沉淀出来。
最后是人。产品经理、BA、SA 还没有把 AI 用进日常工作,仍习惯在修改后的旧文档上输出新需求。这个维度没有捷径。态度不变,工具很难发挥作用。这五个维度里,知识和人更容易被低估。工具可以买,流程可以改,但知识与习惯需要长期积累,也是我觉得比较难的一关。我见过不少团队买了 AI 工具,最后只是把 PRD 写得更快,需求质量没有变化。工具只作用在「写」这一层,没有动流程、知识和协作方式。
为了把「需求过程到底要走到哪」说清楚,我用一条成熟度阶梯来定位:L0 纯手工,L1 辅助编程,L2 部分自动化,L3 有条件自动化,L4 高度自动化,L5 完全自动化。
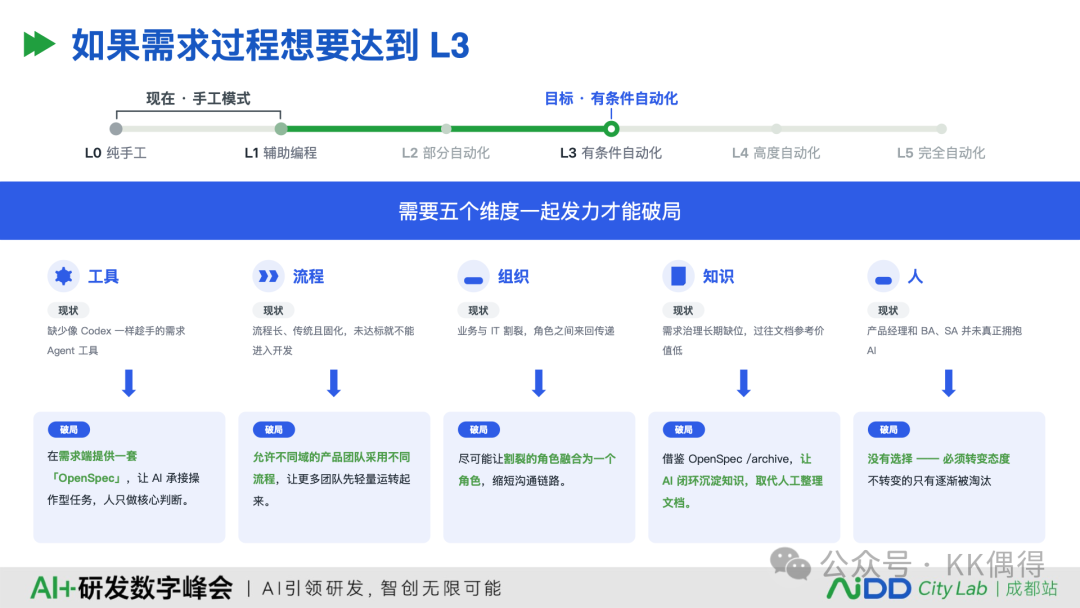
我接触到的团队,大多还在 L1–L2:AI 能写初稿、能总结访谈、能生成测试场景,但流程还是人驱动,上下文靠人搬运。到了 L3,AI 不只是多做几个任务,它开始进入一条有门禁的流程:它知道下一步是什么、产出要满足什么格式、什么时候需要停下来等人确认。L4 的变化则是「门禁从人确认变成系统校验 + 异常介入」。
L3 和 L4 的差别,主要在人在环内还是环上。L3 是 Human in the Loop,人在每个关键节点确认;L4 是 Human on the Loop,人在系统外监督,异常时介入。L3 的前提是明确的流程、模板、HITL 检查点;L4 的前提是稳定的 Baseline、明确的任务分类、可视化的运行看板。L3 的典型风险是人成为瓶颈、HITL 排队;L4 的典型风险是基线漂移、异常无人裁决。
把成熟度放回到具体工作里,会更容易理解。以需求调研为例,L2 是 AI 总结访谈、人整理成文档;L3 是 AI 按模板产出 research.md、人确认事实与结论;L4 是多源收集、标注置信度、人只抽查异常。需求拆分也一样:L2 是 AI 生成 Story 草稿、人调整边界;L3 是 AI 按 storymap 模板拆分并做覆盖对账、人确认;L4 是 AI 在基线内自动拆分、系统校验覆盖、人处理冲突。
原型和验收也是同样的递进:从「AI 生成、人筛选」,到「AI 按规范生成、人确认」,再到「AI 生成多套方案/自动执行、人选择或处理失败」。
所以我一直觉得:仅靠单点工具,很难走到 L3。它需要工具、流程、组织、知识、人五个维度同时动。L4 更像是系统稳定性问题,而不只是模型能力问题。
一个业务组织的运转,是三层嵌套的循环。最外层是一个业务域/产品族,从规划启动到价值回检;中间层是一个专题/项目,从启动到价值回检;最内层是特性需求,从识别到上线。
以 OpenSpec 为代表的规格驱动开发(SDD)实践,解决的是最内层。它的起点是一个「变更(Change)」:一个提案的起点,是设计方案已经确定、代码改哪里怎么改、解决什么业务问题都已经确定。它跑通的是一条很干净的单 Change 管线:提案 /opsx:propose,编写规范,验证,实现 /opsx:apply,归档 /opsx:archive。更完整的脚手架还会在提案前后加探索与原型,但核心仍然是一个变更的完整流程。
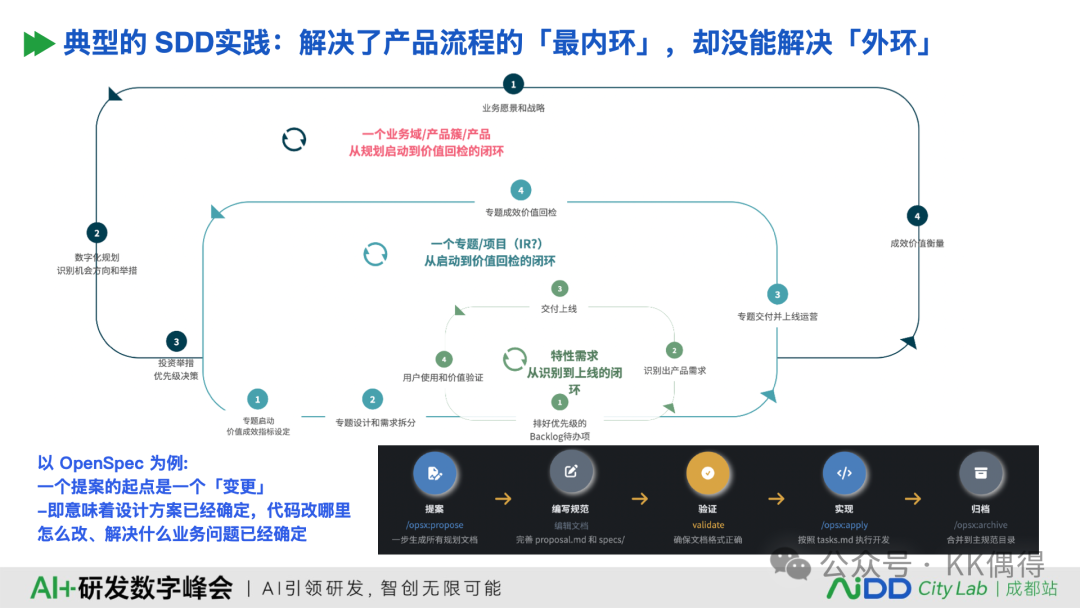
这条管线本身没有问题,它把「意图 → 规格 → 代码 → 归档」跑得很扎实。问题在于它的左边没有东西:从业务想法到可分析的需求这一段外环,仍然以人工为主,工具缺位、流程固化、知识不沉淀。
于是就有了这次分享要回答的问题:怎么让 AI 把外环也加速起来,让需求过程同样达到 L3/L4?更合适的做法,是在 SDD 的基础上往外扩展,不必推翻它。往外扩展的第一步,是改变需求产出的组织方式;先加流程往往解决不了问题。
二、把 AI 扩展到产品规划和需求端
如果说第一部分是在解释「为什么」,这一部分就是回答「怎么做」。
把 AI 扩展到产品端到端,要从产品规划开始,需求文档只是其中一段;重点是把规划、需求、流程和知识资产连成一条链,而不只是把 PRD 写得更快。这条链大致是:先决定做什么,再把决定变成 AI 能用的需求,然后按团队复杂度设计流程,走完流程后再把确认过的交互落成 Specs,最后用基线和指标让知识持续沉淀。
如果你是团队管理者,读这一部分时可以带着三个问题:我的团队该从哪里开始,哪些需求值得走重流程,怎么判断这套方法有没有跑偏。命令怎么用可能不是重点,更重要的是这套东西能不能让团队少返工、少等待、少扯皮。
先往上游看:产品规划。
产品规划也是知识资产的一部分,而且是最上游的那部分。讲到这里,很多产品经理会问:需求工程是下游,产品规划在上游,AI 能帮上什么?我的看法是,产品规划是 AI 容易被低估的场景,也很需要人判断。规划阶段的不确定性很高,AI 不能替你做「下注」,但可以把下注前的信息处理做得更充分、更可追溯。产品规划阶段使用 AI 的原则,是把它用在信息处理的上限,不要用在决策的下限。
市场与竞品扫描,AI 可以抓取、归纳、对比、生成候选机会,人判断哪些信号值得相信;用户与访谈分析,AI 可以聚类原始反馈、提取痛点、生成画像假设,人判断痛点的商业价值;机会评估,AI 可以按影响、频次、成本、风险生成评分与情景,人决定资源投向与优先级。
路线图和 Epic 定义也是如此。路线图起草,AI 可以生成多套阶段方案、依赖与里程碑,人做取舍、承担结果;Epic 定义,AI 可以把机会转成一页纸 Epic,人确认边界与验收。
规划的输出最好不只是一份 PPT。它至少要沉淀成三类资产:PRODUCT.md,产品定位与决策准则;ROADMAP.md,阶段目标,每个阶段条目对应一个或多个 Epic;以及每个 Epic 的一页纸定义,写清楚为什么做、为谁做、成功标准、不做什么。这三类资产一旦结构化,需求流程才有稳定的输入。否则,需求侧再努力,也很难补上规划本身的模糊。
一个可操作的最小流程是:先用 AI 做机会扫描与访谈聚类,产出候选机会;人筛出值得下注的机会;再用 AI 生成 2–3 套路线图方案与依赖分析;人做取舍;最后把选中的机会写成一页纸 Epic,进入需求流程。AI 负责把信息处理得更充分,人负责把方向押得更准。
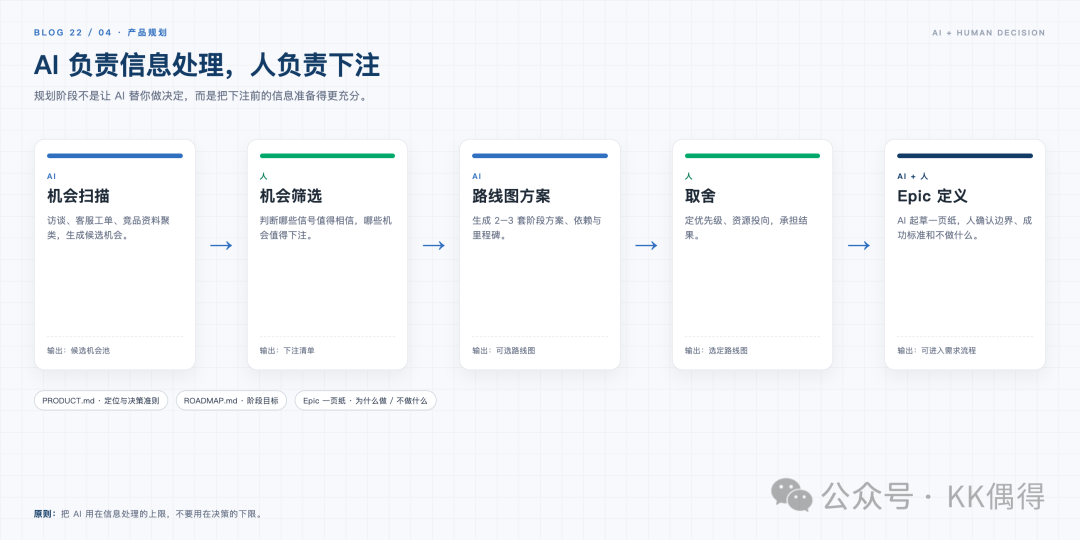
举个具体的例子。在一个会员体系 Epic 里,AI 可以先把 20 多份访谈、客服工单和竞品资料聚类成 6 类痛点,再按影响面、频次、实现成本生成机会评分;人只需要判断哪两类痛点值得下注,以及哪些明确不做。
落地建议: 不要一上来就让 AI 生成整份路线图。先让它做机会扫描和访谈聚类,人只负责筛选和排序;这样既用了 AI 的信息处理能力,又不会把方向判断外包给模型。
规划定的是方向,方向之下才是需求。你的团队现在可能还在写 PRD。下一步的重点,是让 PRD 变成 AI 能直接读懂、直接执行的结构。写得更长,帮助不大。
我的判断是,绝大多数需求产出,都可以结构化,也可以 HTML 化。AI 读不懂 PRD,原因往往不在模型,而在 PRD 本身没有为机器执行设计。具体落到三个动作上。
第一,能结构化的都结构化。叙述性的 PRD 对 AI 不友好:需求点不条目化、验收口径不明确、变更与决策难以审计。把需求拆成可分类、可分层、可机读的结构,是让 AI 能接手的前提。
第二,用统一的 Skills 和模板约束产出。让规划与需求产出规范化、一致化,格式上采用 Markdown/HTML,兼顾人和 AI 两种读者。
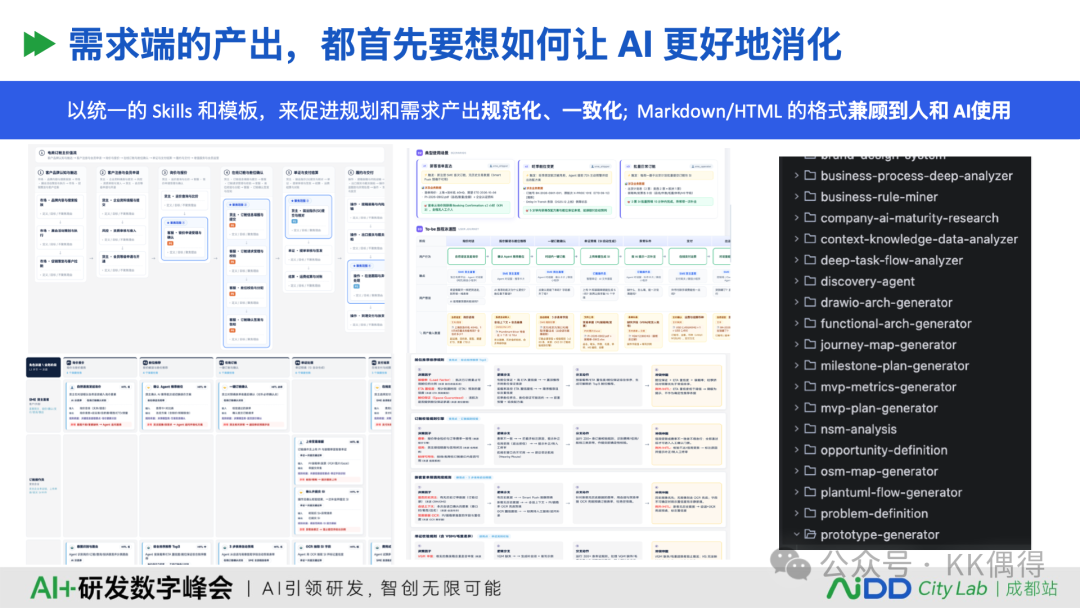
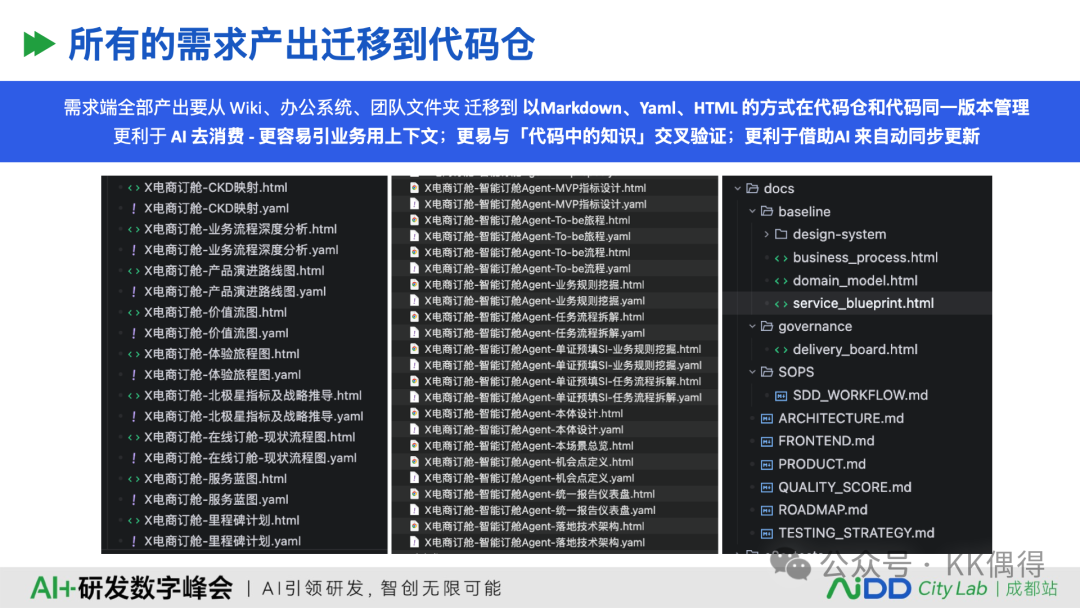
第三,需求产出尽量迁移到代码仓。从 Wiki、办公系统、团队文件夹搬进代码仓,用 Markdown、YAML、HTML 和代码同一版本管理。这样做有三个直接好处:更容易引用业务上下文;更容易和代码里的知识交叉验证;更利于借助 AI 自动同步更新。
传统 PRD 和 AI 能直接执行的 Specs,差别不只在格式。PRD 是叙述性长文、截图、附件;Specs 是 Markdown/YAML/HTML,结构化、可 diff。PRD 的需求粒度是章节式、条目不清;Specs 是需求点、规则、场景、验收分层。PRD 的验收口径是模糊描述;Specs 是 Gherkin/Scenario,可执行、可测试。
变更和追溯上的差别更大。PRD 的变更历史是版本号加人工记录;Specs 是 Git 版本、变更集、归档。PRD 的追溯关系靠人记;Specs 是承诺项、Story、Spec、测试之间可追溯。PRD 的复用方式是复制粘贴;Specs 是基线、模板、Skills 复用。
容易踩的坑: 很多团队把「结构化」理解成把 PRD 改成更长的模板。结构化的关键,是让需求点、规则、场景、验收能一一对应;如果只是换了格式,AI 还是接不住。
这套东西也可以理解为需求侧的 Harness:与其说它是一条更长的提示词,不如说它是把上下文、模板、工具、门禁、反馈回路一起交给 AI。Harness 的作用,是让模型在正确的约束里工作,而不只是让它更聪明。所以它需要和流程、门禁、基线一起设计,单买一个工具解决不了问题。
落地有门槛,主要卡在两件事上:Skills 和 Git。这两项的上手成本都大约 2 小时。难点在于每次都这么用:养成习惯、坚持规范。单人会用 Git,不等于多人可管;复杂大项目里的版本管理,需要把需求相关 docs 拆到独立 repo,做成 submodule 挂到项目主仓,顺带做权限隔离。工具的学习成本不高,成本主要在习惯与协作纪律上。很多团队卡住,问题通常不在学不会,而在「这次先这样」。
产出变成契约之后,才谈得上按团队设计流程。你的团队更像哪一种?
团队和团队是不一样的。小型工具团队,PM 一人可定,协作界面 1–2 个角色,影响面是内部工具、可回滚,规则简单,生命周期往往是一次性的;单业务产品团队,业务与产品融合,3–4 个角色,影响单条业务线,规则中等、有业务编排,持续迭代 6–18 个月;跨部门业务产品团队,业务与产品分离、多方会签,5+ 角色、跨部门,影响资金、合规、多业务线,规则密集、强合规,生命周期长、跨版本复用。平台团队自研的 CI/CD 脚手架、电商 App 的会员体系、车企的整车订单履约系统,大致对应这三类。
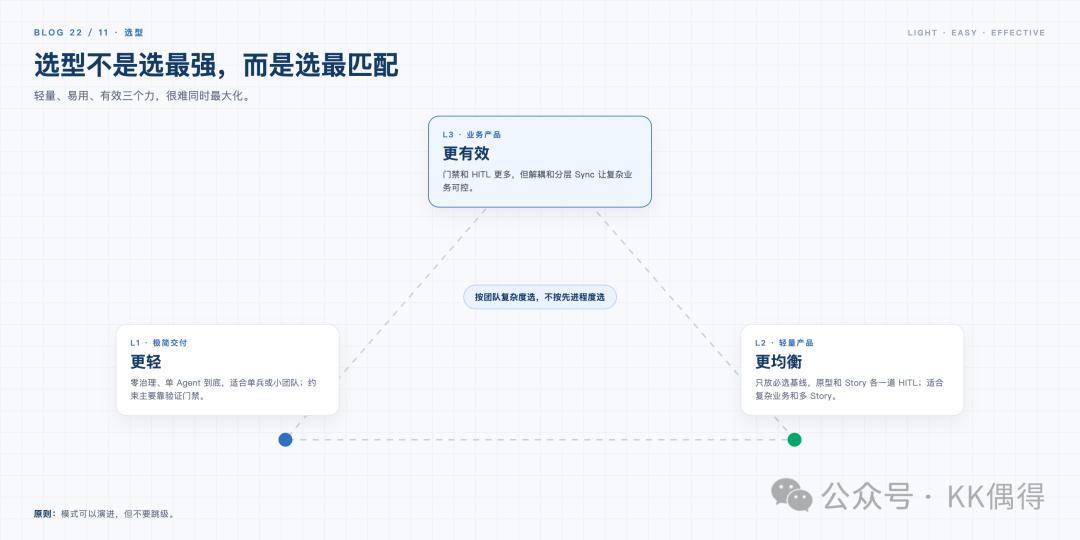
对应这三种团队,脚手架也有三种形态。L1 极简交付,工作单元是单 Change,核心是最小管线和验证门禁;L2 轻量产品,工作单元是 Multi-Story,核心是规划/业务基线加 Story 循环;L3 业务产品,工作单元是 Epic/Story,核心是需求侧与交付侧解耦、分层同步。
这里的 L1/L2/L3 是脚手架模式,不是前面的自动化成熟度。两者可以组合:一个 L3 业务产品团队,需求过程可能还在 L2;一个 L1 工具团队,也可能因为流程轻、工具顺,在需求成熟度上先跑到 L3。
这里说的 Agent,更接近按角色配置的 AI 工作台:PM Agent 承接需求侧操作,Engineer Agent 承接交付侧操作,Lead 负责治理、交接与归档。
落地建议: 不要按部门大小选模式,按决策路径、协作界面和影响面选。一个 50 人的后台团队,如果 PM 一人可定、影响面可回滚,也可能适合 L1。
L1 极简交付。 只做一件事:把「意图 → 需求 → 规格 → 代码」这条原始管线跑通,零治理、最轻。工程侧由 Engineer Agent 主力承担,Lead 负责治理与归档,对应 Explore → Propose → Apply → Sync → Archive 五个环节;更完整的实现会在 Propose 之后、Specs 之前插入可选的 Prototype。
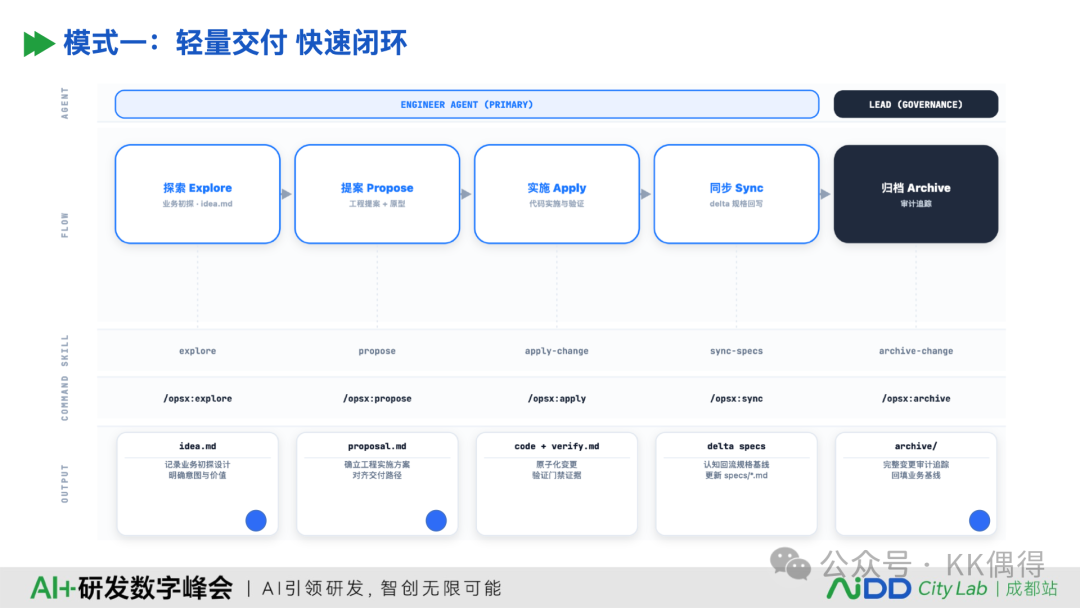
不同类型的变更走不同分支:新功能涉及 UI,就先做原型,再写规格和设计;不涉及 UI,就跳过原型;后端或技术任务跳过原型,没有外部行为变化就 skip_specs;Bug 只在涉及 UI 时做原型,规格只修正受影响场景,设计做根因分析。L1 的价值是快,不是全。它目前主要靠验证门禁兜底,不要在这里硬塞业务基线,也不要引入需求流程。什么时候升级?当你开始出现多 Story 并行、方向容易漂移、多人协作需要统一基线时,就该进入 L2。
L2 轻量产品。 当团队开始服务一条真实的业务线,就需要引入「规划基线」与「业务基线」作为护栏。基线只放必选,护栏兜住方向,多条 Story 在护栏内循环拆解、逐条冻结。最小治理集合是 PRODUCT / ROADMAP(为什么做、现在做什么)、domain_model(业务结构)、business_process(L1/L2 流程);按需增强的是 service_blueprint(跨角色协同)、delivery_board(管理监督)。
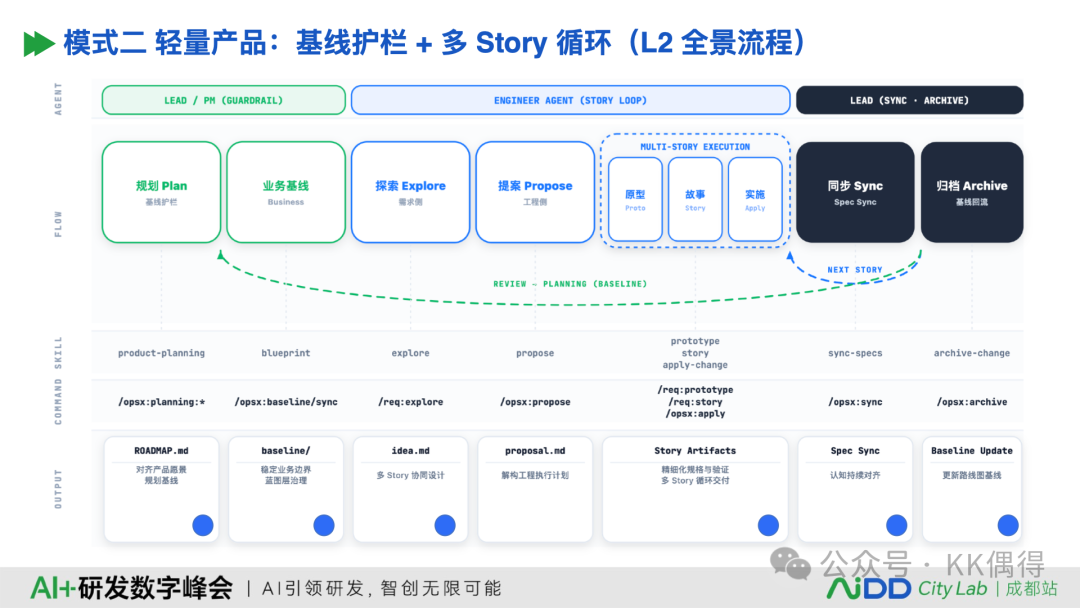
Lead/PM 负责规划与业务基线,Engineer Agent 在 Story Loop 里做「原型 → 故事 → 实施」,完成一轮后按 Story 回到探索,直到整个变更收口,再进入 Spec Sync 与归档。这里的原型不追求高保真,一份轻量 HTML 就够,目的是让 Story 在实施前被看见、被确认。L2 更看重基线是否精简,文档多少不是重点:基线一重,团队就会绕开它;基线一轻,方向又兜不住。
L1 和 L2 的边界相对清楚;L3 因为跨部门、多角色,值得单独展开。
双轨解耦。 如果你的团队属于第三类,也就是跨部门、强合规、多角色协同,比如 Web、运营后台、小程序和 Agent 同时存在,那就需要做需求侧与交付侧的深度解耦。
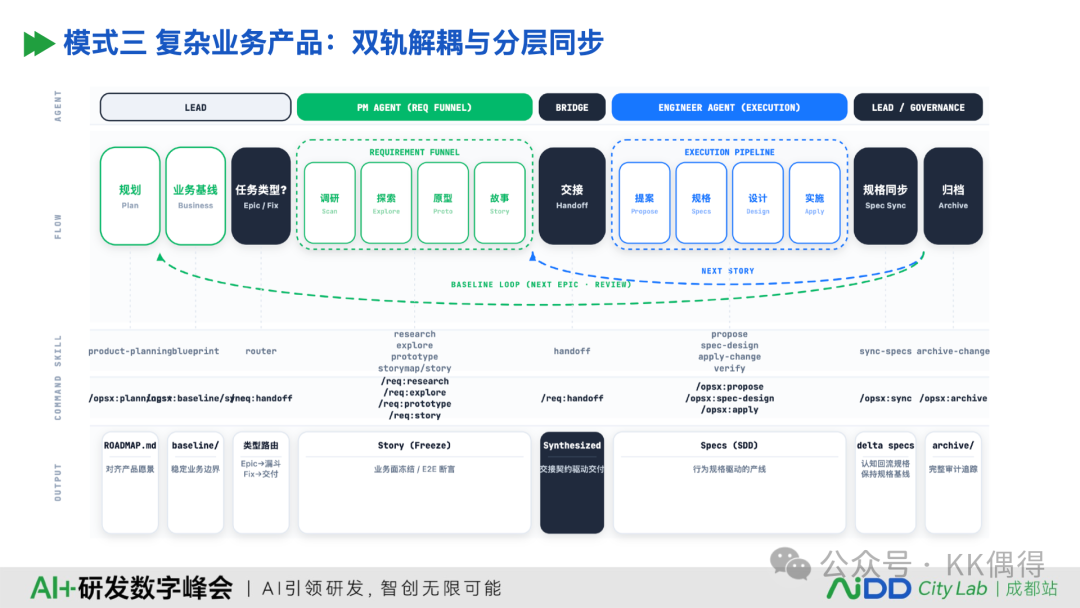
需求侧由 PM Agent 主导,走需求流程:调研(Scan)→ 探索(Explore)→ 原型(Proto)→ 故事(Story);完整的六步还包括需求拆分(Storymap)与交接(Handoff)。中间由 Lead 做交接,把已冻结的 Story 合成开发侧的 proposal。交付侧由 Engineer Agent 主导,走执行管线:提案(Propose)→ 规格(Specs)→ 设计(Design)→ 实施(Apply)。治理侧由 Lead/Governance 负责规格同步(Spec Sync)、归档(Archive),Epic 收尾做 Baseline Sync。需求侧不生成 specs;行为规格由交付侧按 capability 拆分生成。这样业务面和技术面各自演进,不会互相污染。
为什么要把两侧拆开?一个直接原因是变化速率不同:业务语义变化慢,实现细节变化快。如果放进同一个变更目录,任何一次实现调整都会污染业务评审记录。拆开之后,业务面一旦冻结就能触发后续流程,交付侧的技术演进也不会反复冲击已经冻结的业务语义。
举个具体的流动方式:一个会员权益 Story 在需求侧冻结后,handoff 把它合成开发侧 proposal;交付侧再拆 specs、design、tasks,完成实施与验证;归档前做 Spec Sync,把 delta specs 合回主规格;然后回到需求侧做下一个 Story。直到这个 Epic 的 Story 全部归档,才做一次 Baseline Sync,把新的领域模型、流程节点和路线图状态回流到基线。
这里有一条重要的适用范围路由:大块 Epic 走需求侧流程,交接后进交付侧;Bug Fix、Tech Debt、简单功能修改直走交付侧,从 /opsx:propose 起,不进需求侧。我的理解是,工程化要根据需求类型决定流程深度,不必让什么需求都走同一条重流程。简单需求直走交付,复杂需求深度受控,才能避免「小需求排队等大流程」。
多 PM 协作也是 L3 绕不开的问题。在小型产品团队,只有一个产品经理/BA;在稍大的业务产品团队,可能有 2 个甚至多个 PM/BA。需求侧工作区要能支持多 PM 在同一 Epic 下分工,STATUS.md 和 story-list.json 是统一状态源,避免「各写各的」。
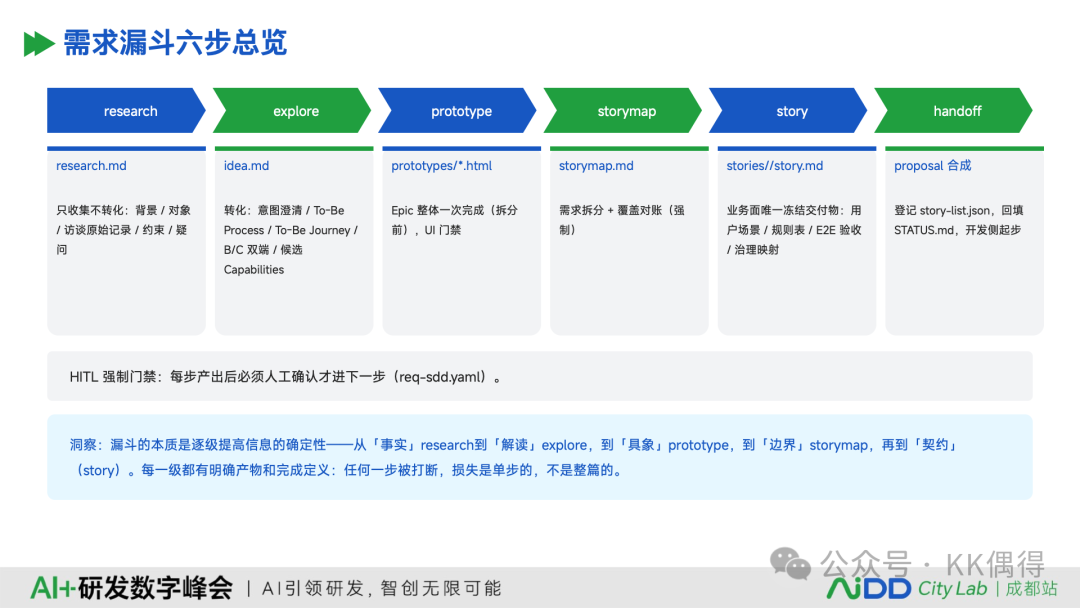
六步流程。 L3 的需求侧具体怎么跑?就是下面这六步。
需求被当成一个整体项目、采用「写完 → 评审 → 确认」的串行模式时,任何一个细节不确定都会阻塞整篇文档签发。需求流程换了个组织方式:把需求加工拆成六个有明确产出与准入准出的步骤。
第一步是需求调研。只收集不转化:背景、干系人、访谈原始记录、约束、疑问、结论;先调研,再据结果识别 Epic 并创建目录。第二步是探索。把调研转化为产品设计思路:To-Be Process、To-Be Journey、候选 Capabilities。第三步是原型。在拆分前对 Epic 整体做一次;它的作用是对齐认知,不是做高保真设计稿。原型受 HITL 锁定:没有已确认原型,不得拆分、不得交接。
第四步是需求拆分。用 storymap 做覆盖对账:Epic 的每个承诺项都要有 Story 承接,既防漏项,也防范围蔓延。第五步是 Story 交付。Story 是业务面冻结的交付物,包含用户场景、规则表、E2E 验收、治理映射。第六步是交接。把已冻结的 Story 合成开发侧 proposal,登记 story-list.json,回填 STATUS.md,交付侧起步。
六个环节都设有 HITL 门禁:每一步产出后需要人工确认,才能进入下一步。这是 L3 的典型特征:AI 可以承接操作,但不能跳过判断。
这六步里,有三条纪律需要守住。
第一,只收集不转化。调研阶段要求只记录原始访谈、事实与数据,防止过早进入方案设计导致认知闭塞;事实和解读要分开。
第二,原型是认知对齐的载体,不是高保真设计稿。它的作用是用较低的成本达成共识,让分歧发生在交互演示里,而不是上线后。
第三,覆盖对账。拆分环节要求把原始承诺项与交付 Story 逐一关联,既防漏项,也防范围蔓延。在示例里,账户体系这条线最终是 14/14 全部对账。
容易踩的坑: 常见的三个坑是:什么需求都塞进六步流程,结果小需求排队;把原型当高保真设计稿,评审变成挑视觉;没有确认原型就拆分,后面返工。
这套流程在做的事,是逐级提高信息的确定性:从「事实」(research)到「解读」(explore),到「具象」(prototype),到「边界」(storymap),再到「契约」(story)。每一级都有明确的产物和完成定义,因此任何一步被打断,损失是单步的,不是整篇的。
还有一个反直觉但很关键的取舍:最小冻结单元是 Story,不必等到整个 Epic。一个 Story 的业务规则一旦冻结,立即交接进入开发侧,后续 Story 继续在需求侧加工。冻结单位越小,等待链条越短,需求与交付两条管线才能并行起来。
六步走完,最后都会落到一份规格上。这更像是把「文档」变成「可执行的契约」,而不只是给 PRD 换个名字。两者的生产逻辑不同。PRD 的读者是人,Specs 的读者是人和 AI;PRD 是一次性交付、评审后归档,Specs 是持续演进、随变更同步。
PRD 的变更方式是重写文档、口头同步,Specs 是版本控制、delta 合并、归档;PRD 的质量判断是评审是否通过,Specs 的质量判断是是否能被 AI 执行、被测试验证。所以,Specs 的价值在于把需求变成可执行、可验证、可追溯的资产,长度并不是重点。这个转变,是刚才那套流程的前提,也是后面基线、指标的基础。
从确认过的原型走到 Specs,中间有一个反向沉淀的过程:原型确认,提取规则,编写 Specs,进入代码仓。原型确认之后,它的价值不应该止于「看过、同意」。
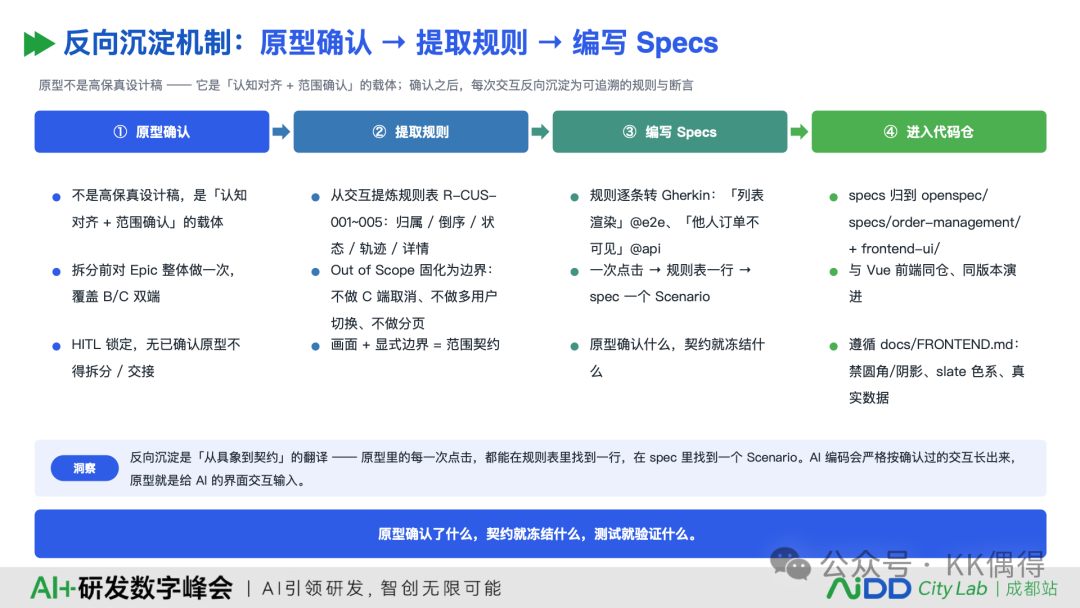
从确认过的交互里提炼出规则表,例如 R-CUS-001~005:归属、倒序、状态、轨迹、详情。把显式排除项固化为边界:不做 C 端取消、不做多用户切换、不做分页。
规则逐条转成 Gherkin,例如「列表渲染」标 @e2e、「他人订单不可见」标 @api。Specs 归到 openspec/specs/ 下,与前端同仓、同版本演进。
一句话:画面加显式边界,等于范围契约。原型里的每一次点击,都能在规则表里找到一行,在 spec 里找到一个 Scenario。原型确认什么,契约就冻结什么,测试就验证什么。
举个更具体的例子。原型里有一个「我的订单」列表:默认按时间倒序、只显示当前账号的订单、点击进入详情。确认之后,它会被拆成三条规则:R-CUS-001 归属当前账号,R-CUS-002 按创建时间倒序,R-CUS-003 点击进入详情;再转成三个 Scenario:列表渲染标 @e2e、他人订单不可见标 @api、详情字段完整标 @e2e。原型里的一个页面,就这样变成了可执行、可测试的契约。
落地建议: 每次原型确认后,先让 AI 生成规则表草稿,人只补三类东西:归属、边界、异常。这三类补齐,Specs 基本就能用。
这一步也是「从 PRD 到 Specs」的核心动作:把确认过的交互变成可执行、可测试、可追溯的规格。PRD 写得更长,帮助不大。
规格进了代码仓,接下来要解决的是它怎么持续保鲜。
需求产出要「活」,就得面对文档容易过时的问题。写更多文档解决不了问题,关键是沉淀会被持续消费的基线。
业务文档说 A,代码实现逻辑是 B。这种「知识漂移」在单团队、短周期里可能不明显;一旦多 Epic 并行、跨角色协作,它就会让系统沦为黑盒。Baseline 是领域语义的守恒层:它不记录每一次变更的细节,但守住业务边界、流程节点、能力分布和路线图方向。
基线资产。 基线资产有四类:domain_model 治理业务边界、BC→能力映射、不变量;business_process 治理 L1/L2/L3 流程节点,是验收引用源;service_blueprint 治理跨角色泳道、旅程阶段、能力状态;ROADMAP / PRODUCT 治理排期、阶段边界、产品定位。基线不是越多越好:L2 只放必选,L3 再按需增强。基线一旦变成「文档工程」,就会变成没人看的文档。
分层同步。 同步也有节奏问题。这里用了一套分层同步机制:Spec Sync 是 change 级,每个变更归档前合并 delta specs,保证下一个 Story 基于最新规格;Baseline Sync 是 Epic 级,Epic 全部 Story 归档后统一回流,到点做 Sync Assessment,无变化也显式记录 No-op。
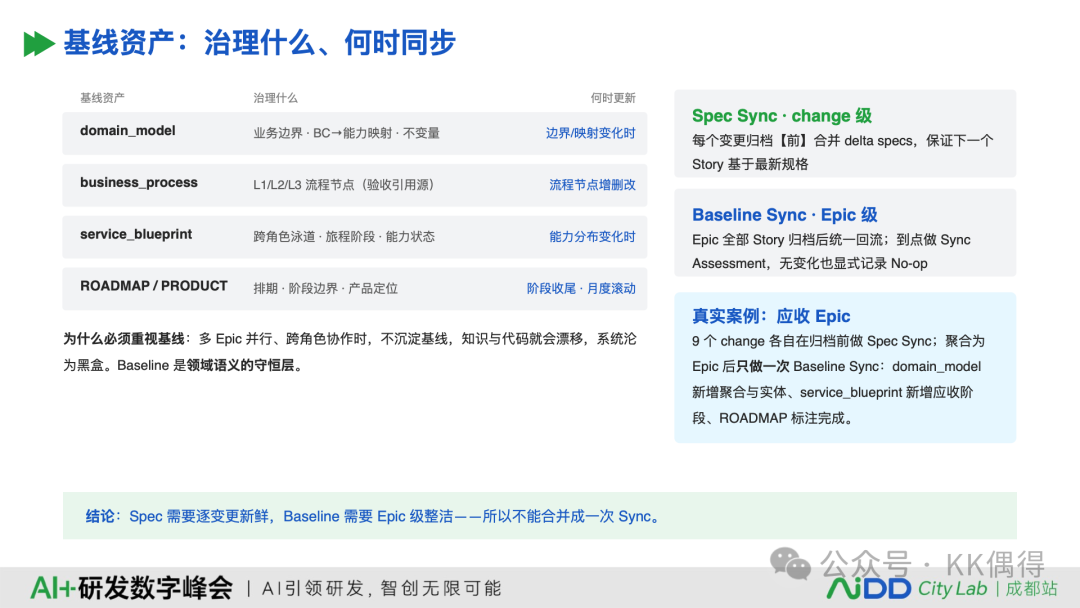
这两层同步不能合成一次,原因是节奏不同。真实案例是「应收」这个 Epic:它下面 9 个 change 各自在归档前做 Spec Sync;聚合为 Epic 之后,只做一次 Baseline Sync:domain_model 新增聚合与实体、service_blueprint 新增应收阶段、ROADMAP 标注完成。
结论很清楚:Spec 需要逐变更新鲜,Baseline 需要 Epic 级整洁;两者的节奏不同,所以不能合并。还有一个容易被忽略的纪律:无变化也要记录 No-op 及理由。否则基线会在「这次先不更新」中慢慢腐蚀。
容易踩的坑: 基线只写不更新,或者只更新不记录 No-op,半年后没人知道哪条基线还有效。
三层指标。 只看一个指标,很容易误判。生成率高,只能说明工具用得多;WIP 高,只能说明队列堵,不说明交付有没有变快。更完整的看法是三层一起看。
L1 是 AI 效能层,看工具有没有真的用起来:需求侧 Agent 的覆盖率、Session、Token、Skill / MCP 使用情况,以及上下文资产有没有积累。L2 是工程质量层,看质量有没有被牺牲:HITL 一次通过率、覆盖对账漏项数、需求返工和回滚。L3 是价值交付层,看业务有没有真的变快:Story Lead Time(想法到 handoff)、需求交付周期、变更周期,以及 AI 需求和非 AI 需求的交付对比。
在制 Story 数(WIP)是流量信号,用来解释 L3 的周期为什么变长,不单独当成绩效指标。三层要一起看:只看 L1,容易高估提效;只看 L3,又很难定位问题。几个典型的异常信号是:L1 覆盖率涨、人均 Session 不涨,说明工具装了但没用起来;L2 用量涨、缺陷和返工也涨,说明在用质量换速度;L1、L2 都正常,但 L3 的交付周期不降,说明瓶颈不在当前环节,要往别处找。
需求侧的几个过程指标可以放进这个框架:HITL 一次通过率、覆盖对账漏项数放在 L2;Story Lead Time、需求交付周期放在 L3;在制 Story 数作为流量信号,辅助解释周期变化。这样既能看到工具有没有用起来,也能看到质量有没有守住,还能看到业务有没有真的变快。
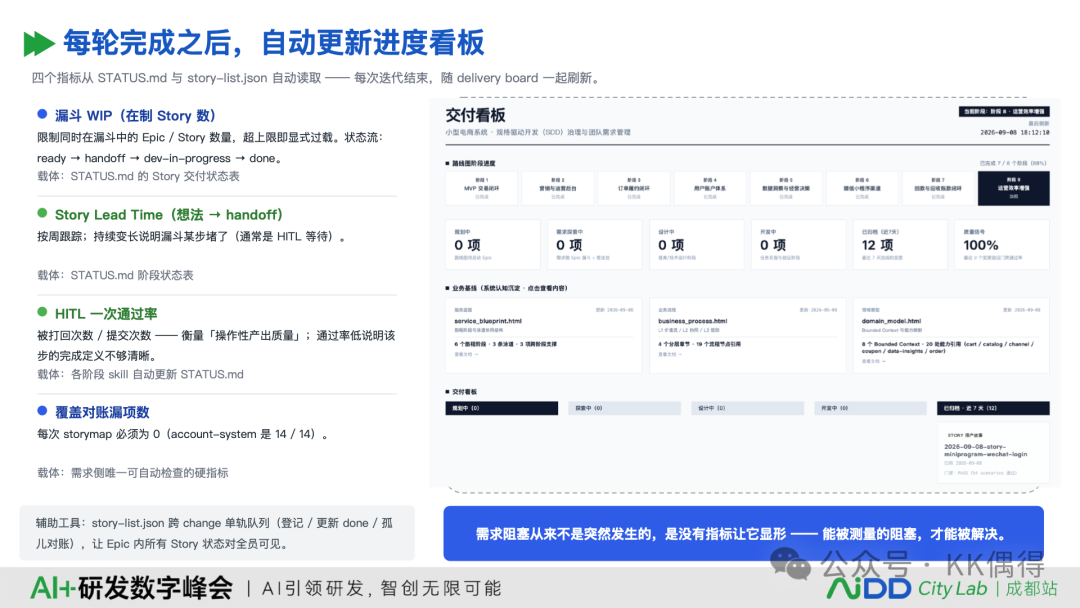
看板上的在制 Story 数、Story Lead Time、HITL 一次通过率、覆盖对账漏项数,就是这套三层框架在需求侧的具体落点。
落地建议: 周会不要只看生成率或 WIP。先看 L1 有没有用起来,再看 L2 有没有返工,最后看 L3 的交付周期有没有下降;三层对不上,就先别急着推广。
看板本身不复杂,但它把在制数、等待时长、返工率、漏项这些原本模糊的感受,变成了可以被管理的东西。能被测量的阻塞,才能被解决。
把基线、同步和指标放在一起看,就能理解为什么说基线是 L4 的前提。L4 更看重系统是否稳定,而不只是 AI 是否更自动;稳定的 Baseline、明确的任务分类、可视化的运行看板,是 Human on the Loop 的三个前提。没有基线,AI 越自治,漂移越快;没有度量,人越放手,风险越不可见。所以从 L3 到 L4,门禁不该拆,而是要从「人盯」变成「看板盯」。
如果你是团队管理者,读完这一部分,可以先做三件事:选一个边界清晰的 Epic,指定一个对基线负责的人,先定三个门禁。这三件事不需要等工具采购,下一次需求评审就能开始。
前面讲的是方法。方法能不能长在组织里,取决于角色、机制和节奏。很多团队并不缺流程设计,难的是流程设计完以后,人还是按老习惯工作,几个月后又退回去了。转型的阻力往往不在工具,而在习惯和利益边界;组织落地不能只发工具,还要处理角色、考核和协作方式。
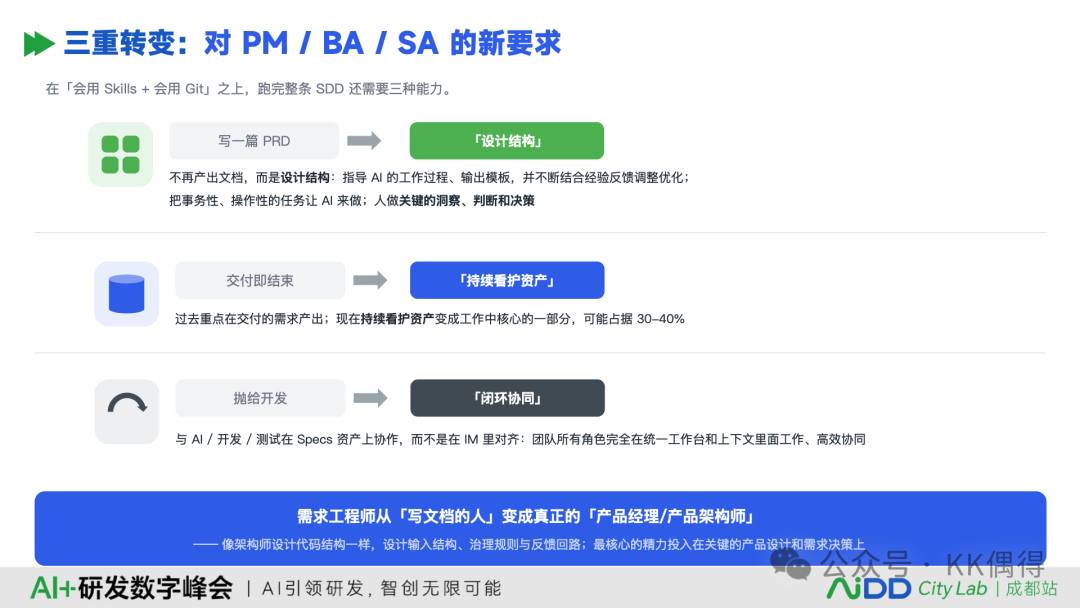
三重转变可以概括为三句话:从写 PRD 到设计结构,从交付即结束到持续看护资产,从抛给开发到在 Specs 上协同。
落到组织上,就是三件事:角色从文档作者变成结构设计者;业务和 IT 的边界往中间靠;团队里有一个对治理负责的角色,比如 Lead/Governance,负责交接、门禁、基线和归档。岗位名称可以不变,但责任边界要变:谁对需求的可执行性负责,谁对基线保鲜负责,谁对门禁通过负责。
容易踩的坑: 只发工具不改角色,PM 还是一个人写 PRD,AI 只是帮他打字。
机制上,先抓三件事。
第一,门禁。调研、原型、Story、Verify、Baseline Sync 都要有人确认。先有门禁,再谈自动化;HITL 不是官僚审批,是 L3 的地基。
第二,基线和指标。交付不是终点,基线要有人持续看护,无变化也要记录 No-op。指标按三层看:L1 看用没用起来,L2 看质量有没有守住,L3 看交付有没有变快。不要只看生成率或 WIP。
第三,组织纪律。工具 2 小时学会,习惯靠组织;没有持续的共学、评审和复盘,规范很快会松动。考核也要跟上,只看交付速度,团队还是会回到老习惯。
另外,按类型选路径:简单需求直走交付,复杂需求深度受控,不搞一刀切。
落地建议: 先定三个门禁:原型确认、Story 确认、Verify 确认;不要一开始就上十几个审批点。
落地节奏分三步:先用 1 个边界清晰的 Epic 跑通 L1,验证需求不返工;再在 1 个业务域沉淀基线,让下一个 Epic 能复用;最后才多域、多团队复制。这三个阶段是落地顺序,不是成熟度等级。
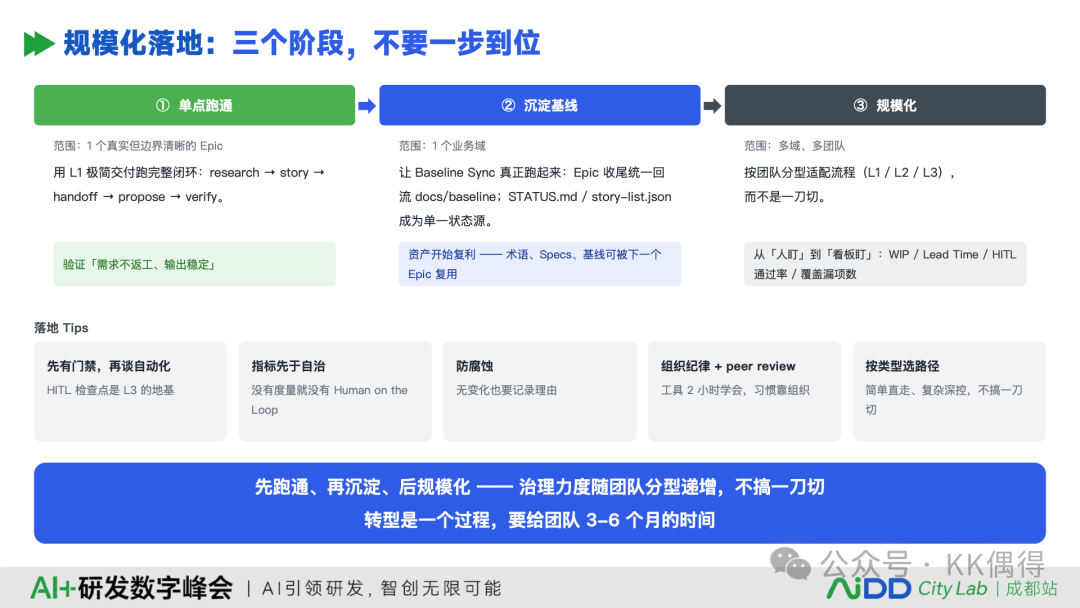
选一个愿意改变的团队,不要从最复杂的团队开始;给 3–6 个月,不要用行政命令一夜切换。
容易踩的坑: 从最复杂的团队开始试点,或者一上来就全公司推广;前者容易失败,后者容易反弹。
选型看团队复杂度,不看先进程度。L1 更轻,L2 更均衡,L3 更有效;模式可以演进,但不要跳级。先用 L1 跑一个真实 Epic,再决定要不要升级。
上面这套流程,我已经放在开源项目 openspec-example ( https://github.com/jkang/openspec-example ) 里。它不是一份说明文档,而是一套可运行的脚手架:需求侧 openspec-requirements/、交付侧 openspec/,加上 agents/skills/commands、schemas/templates、SOP 和迁移脚本。团队如果想参考这套流程开始,可以按下面八步迁移。
第一步,分清「引擎」和「示例」。 只搬 agents/skills/commands、config/schemas/templates、SOP/scripts;specs/changes/epics/baseline/design-system 这些电商示例产物不要一起搬。
第二步,复制与初始化。 运行 ./scripts/migrate-scaffold.sh /path/to/new-project,检查 lead agent、两个 config、schemas/templates/tools 是否就位,保持 specs/changes/epics 为空。
第三步,重写项目配置。 两个 config.yaml 的 context/planning/rules、opencode.jsonc 的 default_agent、AGENTS.md 的角色与路由、init.sh 的测试入口,都要按目标项目重写;只改项目名,会把示例规则带过去。
第四步,初始化规划与业务基线。 重写 PRODUCT.md、ROADMAP.md(每阶段条目即 Epic),录入 domain_model、business_process、service_blueprint;首个 UI Epic 前生成 design-system。
第五步,检查 Skills 和 Templates。 不要拿来就用:逐个看 research/explore/prototype/storymap/story/handoff 六个阶段的 skill,确认产出模板、HITL 门禁、术语和评审清单是否符合团队规范;两个 config 的 rules 与模板要保持一致。必要时先改模板,再跑首个 Epic。
第六步,跑通首个 Epic。 按需求六步流程走 research → explore → prototype → storymap → story → handoff,再进交付侧 spec-design → apply → verify → sync → archive,Epic 收尾做 Baseline Sync。每步都有 HITL 确认。
第七步,扩展能力。 新增 skill/command 时,.agents、.trae、.cursor 三目录同步;新增 capability、流程、design token 要过 baseline sync;新增 Epic 先写 ROADMAP,不要直接在 changes 里规划。
第八步,迁移自检。 两个 config 没有示例残留;specs/changes/epics 为空;PRODUCT/ROADMAP/baseline 已重写;delivery_board 能重新生成,init.sh 能跑通。
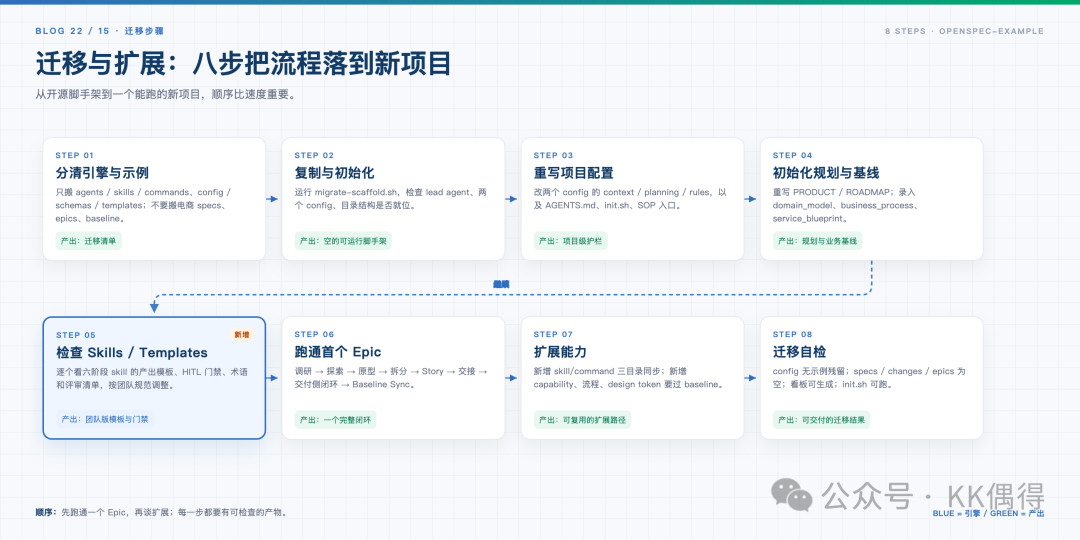
这套顺序的重点不是「快」,而是每一步都有可检查的产物:清单、空脚手架、项目护栏、基线、团队模板、首个闭环、扩展路径、自检结果。
回到最初:瓶颈不会消失,只会沿交付路径往上游转移。当实现不再是约束,需求过程的确定性,就成了下一段要工程化的路。
端到端生产力,看的是等待、返工、漏项有没有降下来,不是单个环节快 10%。从 PRD 到 Specs,本质是把需求从「人看给人看的说明」变成「人和 AI 都能执行、验证、追溯的契约」。从 L2 到 L4,也不是换一个更强的模型,而是把工具、流程、组织、知识、人五个维度一起改造。
大家的产品规划和需求端的实践是怎样的?欢迎一起来探讨~
#AI产品经理#SDD#需求工程#产品规划#规格驱动开发#OpenSpec#AI4SE
推荐活动

北京营销中心
北京通州北京ONE国际广场10层

上海研究中心
上海市浦东软件园

厦门研究中心
厦门观音山国际商务运营中心

海外市场中心
香港中环香港站国际金融中心
 加入智库
 成为客户