作者 / 来源:中智凯灵 / AiDD
缓存使用率是 79%,扩容阈值设在 80%。这时,一个大小已经超过剩余缓存容量的热点文件需要进入缓存。规则还没触发,业务却已经需要更多空间。
这类问题在缓存管理中并不少见。容量使用率能告诉我们缓存用了多少,却不能单独回答下一步该做什么:先扩容,还是先清理?哪些文件值得预热?业务流量回落后,什么时候可以收回资源?做这些判断,需要把缓存状态、集群资源和业务访问情况放在一起看。
由南芥智能发起、与 Fluid 开源社区合作推出的 Fluid-Sinapis,现已发布 V0.1。这个开源系统希望让大模型Agent 承接这部分管理工作:读取多源指标,结合策略生成执行计划,经过复核后,再调用 Fluid 操作技能完成调整。
这个版本先跑通了一条完整流程。围绕这条流程,我们做了几项具体的设计取舍。
Fluid 本身是一款云原生分布式弹性缓存加速框架。它把远端存储中的数据缓存到 Kubernetes 集群本地,通过统一编排和管理缓存资源,提升应用的数据访问性能。
随着业务场景变多,管理上的难点也逐渐显现。Fluid 已经具备弹性能力,但什么时候调整、调整多少、先做哪一步,仍需要运维人员结合业务判断。固定规则适合条件明确的场景;当文件热度、文件大小、可用容量和集群资源同时变化时,决策逻辑也需要随之调整。
Fluid-Sinapis 选择的切入点,就是这部分缓存管理调度。它利用现有基础设施提供的指标和操作能力,把状态分析、方案规划和技能执行组织起来。职责边界也要清楚。缓存引擎仍由 Alluxio、JuiceFS 、Curvine等组件承担,缓存编排继续交给 Fluid,指标存储和查询依托 Prometheus,集群调度由 Kubernetes 负责。底层存储故障、网络分区等系统性故障,也不属于 Fluid-Sinapis 当前处理的范围。换句话说,我们把LLM + Agent 放在缓存管理决策这一层,让它围绕已有能力做判断编排。
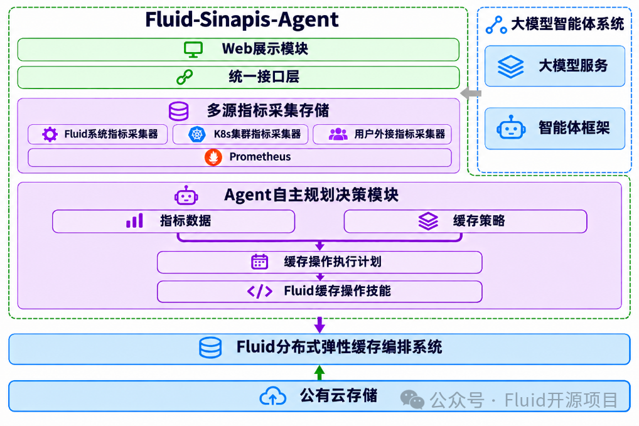
图 1 Fluid-Sinapis 系统架构
让模型做判断,首先要让它看到与判断有关的信息。
仅看缓存使用率,无法知道业务接下来要访问哪些文件;仅看文件访问频率,也无法知道缓存和集群还有多少可用资源。如果这些信息各自留在不同系统里,Agent 就很难把业务压力与缓存状态关联起来。
Fluid-Sinapis 从三个方向汇聚指标。Fluid 侧提供缓存总容量、单个worker 容量、worker 就绪数、已用字节和使用率;Kubernetes 侧提供节点数、节点可分配内存、就绪 Pod 数和空闲内存;业务侧则可以接入文件访问时间、文件大小、访问次数等自定义指标。
这些数据统一结构化后写入 Prometheus,再由 Agent 读取。采集器负责写入,Agent 负责查询,两者通过时序库解耦。这样,决策流程不需要直接适配每一种数据源,采集端也不需要跟着模型调用方式变化。
采集器本身采用可插拔设计。新增一类主动采集的数据源时,可以注册新的采集类,无需修改核心逻辑;业务系统也可以通过外接指标接口提供数据。先把输入组织好,后续策略才有共同的判断依据。
缓存管理会改变实际资源和文件状态。模型给出一个看起来合理的建议,还不足以直接触发操作。
因此,我们没有把整个过程压成一次大模型调用,而是按固定流程推进:定时采集多源指标,分析缓存状态,生成执行方案,独立复核方案,调用 Fluid 技能执行,最后记录执行结果。任何一步不成功,都停止后续动作。
在 Agent Loop 中,模型先读取监控指标,判断当前状态,再按需选择并加载策略类 Skill。Skill 中的规则和操作指导,为后续决策提供约束。模型据此规划操作顺序,形成 Fluid 执行计划,然后进入单独的复核环节。
这里有一个关键区别:规划阶段回答“应该怎么做”,复核阶段检查“这个方案是否可以执行”。把两者拆开,能在方案到达操作层之前多一道检查,也让问题更容易定位到具体环节。
各阶段使用的大模型可以分别配置,也通过使用 SinapisAI按需求与模型能力匹配DeepSeek、GLM等大模型。无论选择哪种模型,读取指标、生成方案、复核和执行的流程保持一致。
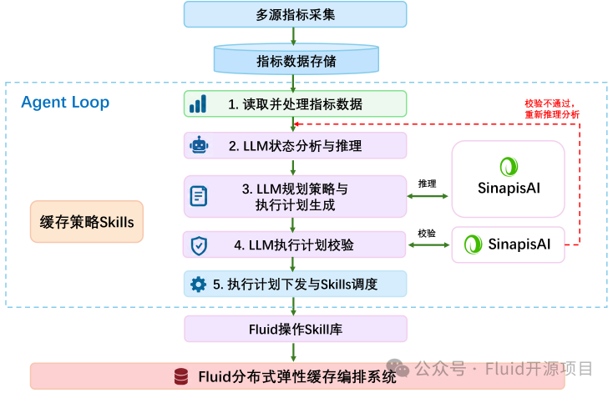
图 2 Fluid-Sinapis Agent 决策与执行流程
分析状态和调用接口,是两类不同的工作。前者需要结合上下文判断,后者需要明确参数、执行约束和结果检查。我们把具体操作封装成 Fluid Skill,让模型通过已有技能完成调整。
V0.1 提供四种操作技能:缓存文件预加载、缓存文件移除、缓存容量扩容和缓存容量缩容。执行计划通过复核后,由相应 Skill 调用底层封装的 Fluid 操作方法。
Skill 按标准规范组织。SKILL.md 中的名称、描述和适用场景,帮助模型判断何时调用;配套脚本负责真正执行。例如,扩容 Skill 的示例会先检查单次扩容容量和总容量上限,再调用 Fluid API,并检查扩容是否成功。执行参数需要落到具体数值,例如单次增加 40GB。
这种分工让模型推理与程序操作各有明确位置。模型可以根据多项指标规划先后顺序,接口调用和参数检查则由技能层承接。后续适配不同缓存引擎时,也需要在这一层处理参数和操作语义的差异。
Agent 在什么情况下更有用?我们更关注那些需要综合多个条件、安排操作顺序的场景。
先看文件选择。假设缓存还剩 10GB,有三个热点文件等待预热,大小分别为 7GB、5GB 和 4GB。只按“访问次数超过 100 就缓存”这一条规则,能判断文件是否达到热度条件,却不能直接决定容量不足时应如何选择。
把文件大小一起纳入判断后,5GB 和 4GB 两个文件可以组成一个占用 9GB 的候选方案。至于它是否比缓存7GB 文件更合适,还要结合访问频率和业务价值。这个例子说明,多指标决策需要处理候选方案之间的取舍;单靠文件大小,也不能证明哪种组合收益最高。
再看扩容时机。开头提到的场景里,使用率尚未达到 80%,但新热点文件已经放不下。如果把剩余容量和文件大小一起考虑,就有条件规划“先扩容,再预热”的操作序列,避免只盯着某个阈值等待触发。
这些例子展示的是决策方式的差别。复杂规则同样可以用代码实现,Agent 的价值在于让多项指标、策略描述和操作规划进入同一套流程。当业务条件变化时,团队可以通过调整策略类 Skill 表达新的判断逻辑,减少反复改动核心代码的负担。具体效果仍需要放到实际业务中检验。
不同业务对缓存的要求并不相同。通用指标和内置策略提供起点,业务自己的访问特征和判断规则,也需要有地方接进来。
Fluid-Sinapis 为此提供了两个扩展入口。一个是用户外接指标:在 config.yml 的 user_system 字段中配置指标,再通过 HTTP 接口发送数据。相关配置支持热加载,修改后无需重启服务。
另一个是自定义缓存策略。用户可以在 server/agent/skills/user_skills/ 目录下编写策略类 Skill,按规范提供 name、description 和 Markdown 正文。框架每轮自动扫描并加载,同样无需重启。
两者可以单独使用,也可以组合使用。业务接入自定义指标后,可以让自定义策略读取这些指标、给出判定,再由 Agent 在规划和复核环节遵循该判定。对于同一操作,如果自定义策略与内置策略给出不同结论,系统以自定义策略为准。
这也改变了部分策略维护的方式。原先需要写进代码的判断,可以通过策略描述和操作指导交给 Agent 使用。但策略仍要写清楚依据什么指标、在什么条件下采取什么动作。描述变短,并不意味着业务判断可以省略。
当前版本的重点,是让指标采集、模型分析、方案复核和技能执行连成一条能运行、能观察、能扩展的流程。接下来,我们会沿着实际管理需求继续补齐能力。
首先是更早判断。计划引入时序预测,把已知业务调度与历史访问曲线结合起来,让扩容有机会提前发生。按现有架构,这可以通过新增观测源和策略来扩展;预测能力目前仍属于后续规划。
其次是扩大运行时适配。当前操作技能面向 Alluxio Runtime,后续计划适配Curvine、JuiceFS、ThinRuntime 等运行时。这里需要处理各引擎的参数差异,让扩容、预热和清理在技能层具有一致、明确的语义。
还有一个更基础的问题,是把缓存收益看得更清楚。当前能够获取缓存容量和文件访问热度,但回源延迟、单文件收益仍是观测缺口。补齐这些信息之后,才有条件进一步量化一次预热、一次清理或一次扩缩容的实际价值。
对我们来说,后续迭代需要持续回答两个问题:Agent 的判断有没有足够依据,执行之后有没有产生预期效果。前者依赖输入与策略,后者依赖更完整的观测。
Fluid-Sinapis 由南芥智能发起,并与 Fluid 开源社区合作推出。项目发起人刘建东希望,用户能借助多样化的大模型智能体能力,更方便地表达系统优化目标和约束,减少策略开发与系统管理负担。Fluid 联合发起人、来自阿里云的车漾,也肯定了把这一思路实现为系统组件并共享给社区的开源协作。
项目采用 Apache 2.0 协议开源,遵循 CNCF 行为准则。欢迎提交 Issue、参与 PR,也可以加入 CNCF Slack,在 #fluid 频道交流。
项目仓库:https://github.com/fluid-cloudnative/fluid-sinapis
V0.1.0 下载:https://github.com/fluid-cloudnative/fluid-sinapis/releases/tag/v0.1.0
快速开始:https://github.com/fluid-cloudnative/fluid-sinapis/blob/master/docs/en/quick-start.md
CNCF Slack:加入CNCF的Slack(https://cncf-slack.netlify.app/),并前往#fluid频道参与讨论
推荐活动

北京营销中心
北京通州北京ONE国际广场10层

上海研究中心
上海市浦东软件园

厦门研究中心
厦门观音山国际商务运营中心

海外市场中心
香港中环香港站国际金融中心
 加入智库
 成为客户